
PDF का अनुवाद इतना कठिन क्यों है? हम असल में क्या बनाए रखने की कोशिश करते हैं?
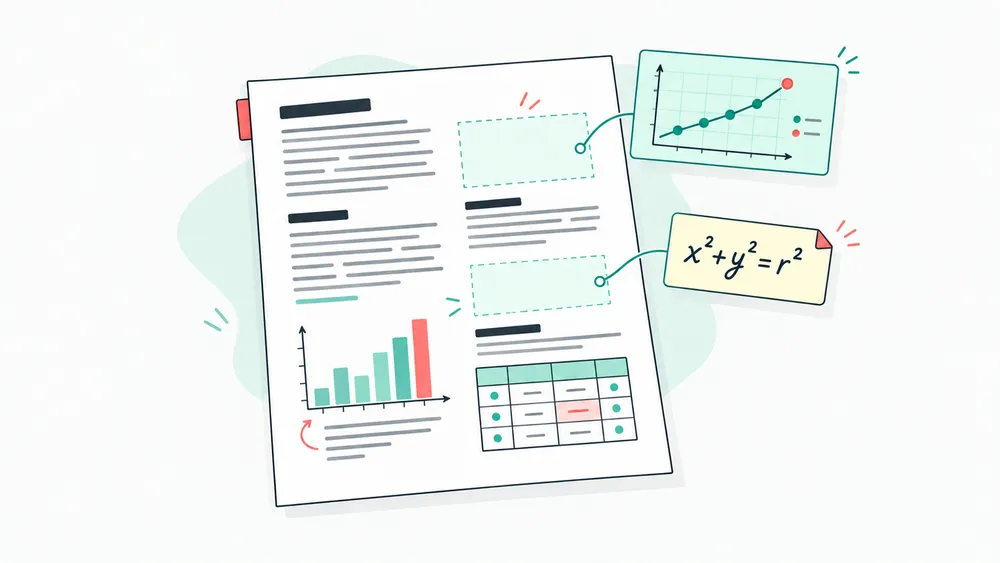
पिछले लेख, “पढ़ने की आदतों से समझें: PDF का अनुवाद करते समय मूल लेआउट क्यों बचाए रखें?”, में हमने पढ़ने की आदतों के ज़रिए समझाया था कि PDF के अनुवाद के बाद केवल अनूदित पाठ बचना पर्याप्त क्यों नहीं है। शोधपत्र, रिपोर्ट या तकनीकी सामग्री पढ़ते समय हम शीर्षक देखते हैं, चार्ट ढूँढ़ते हैं और विवरण जाँचने के लिए मूल और अनुवाद के बीच आते-जाते हैं। मूल लेआउट इन हिस्सों के आपसी संबंध याद रखने में मदद करता है।
लेकिन तकनीकी रूप से इन संबंधों को बनाए रखना आसान नहीं है।
PDF का अनुवाद सिर्फ़ एक भाषा को दूसरी भाषा से बदलकर शब्दों को पुरानी जगह पर रख देना नहीं है। इसमें पृष्ठ के हिस्सों को समझना, यह तय करना कि कौन-सा पाठ एक ही भाग से जुड़ा है, और अनुवाद की लंबाई बदलने के बाद सामग्री को फिर व्यवस्थित करना भी शामिल है।
मुख्य कठिनाई यह है कि PDF अक्सर बताता है कि कोई तत्व कहाँ रखा है, लेकिन यह ज़रूरी नहीं कि वह किससे संबंधित है। अनुच्छेद किस शीर्षक के अंतर्गत आता है? कौन-सा विवरण किस चार्ट का है? सूत्र के किसी चिह्न को कौन-सा वाक्य समझाता है? ऐसे संबंध अक्सर स्थान, शैली और संदर्भ से समझने पड़ते हैं। दो कॉलम, चार्ट, सूत्र और तालिकाएँ इस अनुमान को और जटिल बनाते हैं।
PDF पृष्ठ को सीधे पाठ की एक श्रृंखला की तरह क्यों नहीं पढ़ सकते?
दस्तावेज़ संपादित करते समय आम तौर पर हमें पता होता है कि क्या शीर्षक है, क्या अनुच्छेद है और तालिका का कोई मान किस कॉलम में आता है। PDF पृष्ठ के अंतिम रूप के अधिक करीब होता है: पाठ, रेखाएँ, चित्र और खाली स्थान अपनी-अपनी जगह पर होते हैं, लेकिन उनके साथ हमेशा स्पष्ट संरचनात्मक जानकारी नहीं होती।
एक अनुच्छेद कई स्वतंत्र टेक्स्ट ब्लॉक में बँटा हो सकता है। चार्ट के शब्द उसके चित्रात्मक हिस्सों से अलग सहेजे जा सकते हैं। तालिका केवल रेखाओं और संख्याओं का समूह हो सकती है, जिसमें पंक्तियाँ और कॉलम स्पष्ट रूप से परिभाषित न हों। स्कैन किए गए PDF में पूरा पृष्ठ एक चित्र होता है; पहले उसी चित्र से पाठ, तालिकाएँ और सूत्र पहचानने पड़ते हैं।
इसलिए अनुवाद से पहले कुछ सवालों के जवाब चाहिए:
- कौन-सा पाठ एक ही अनुच्छेद का हिस्सा है?
- कौन-सा शीर्षक नीचे की सामग्री से जुड़ा है?
- दो कॉलम किस क्रम में पढ़ने हैं?
- कोई विवरण किस चित्र या तालिका का है?
- पृष्ठ के हेडर और फ़ुटर को मुख्य पाठ से कैसे अलग करें?
इन संबंधों को समझे बिना पाठ निकालना, खंडों में अनुवाद करना और क्रम से वापस रख देना ऐसा पृष्ठ बना सकता है जिसमें हर वाक्य अनूदित हो, लेकिन पाठक को समझ न आए कि शुरुआत कहाँ से करे।
इसलिए पहला कदम शब्द बदलना नहीं, बल्कि पृष्ठ की संरचना को यथासंभव समझना है। तकनीकी रूप से यह साधारण पाठ पढ़ने के बजाय तैयार पृष्ठ पर शीर्षक, अनुच्छेद, चित्र और विवरण के संबंध दोबारा बनाने जैसा है।
दो कॉलम में असली चुनौती पढ़ने का क्रम है
शोधपत्र और तकनीकी रिपोर्ट अक्सर दो कॉलम में होते हैं। हम केवल दो लंबवत क्षेत्र नहीं, बल्कि पृष्ठ पर पाठक का रास्ता बनाए रखना चाहते हैं: पहले कौन-सा कॉलम पढ़ना है, शीर्षक किस हिस्से का है और फ़ुटनोट कब पढ़ना है।
मनुष्य जल्दी समझ सकता है कि पहले बायाँ कॉलम पढ़ना है, फिर दायाँ। लेकिन किसी प्रोसेसिंग सिस्टम के लिए पाठ की स्थिति अपने आप पढ़ने का क्रम तय नहीं करती।
अनुच्छेद कई पंक्तियों में बँट सकता है और हर पंक्ति अलग टेक्स्ट ब्लॉक के रूप में पहचानी जा सकती है। केवल निर्देशांक या निकाले गए पाठ के क्रम पर चलने से बायाँ कॉलम पूरा होने से पहले सामग्री दाएँ में जा सकती है, शीर्षक गलत जगह पहुँच सकता है, फ़ुटनोट मुख्य पाठ में घुस सकता है या दोनों कॉलम में फैला चार्ट केवल एक कॉलम का हिस्सा माना जा सकता है।
तकनीकी रूप से सिस्टम को पृष्ठ के क्षेत्रों, टेक्स्ट ब्लॉक के क्रम और बीच में आने वाली विशेष सामग्री को एक साथ संभालना पड़ता है:
- कॉलम के बीच की सीमाएँ पहचानना।
- शीर्षक, मुख्य पाठ, फ़ुटनोट, हेडर और फ़ुटर को अलग करना।
- टेक्स्ट ब्लॉक का आपसी क्रम बहाल करना।
- अनुवाद के बाद उपलब्ध कॉलम चौड़ाई के भीतर लाइन ब्रेक फिर तय करना।
- जाँचना कि पाठक मूल क्रम में आगे पढ़ सकता है या नहीं।
अनुवाद लंबा हो जाए तो वह पुराने टेक्स्ट क्षेत्र में नहीं समा सकता। हर पंक्ति को पुरानी जगह पर रखने की ज़िद से पाठ एक-दूसरे पर चढ़ सकता है या बहुत अधिक खाली जगह बन सकती है। अच्छा पुनर्निर्माण हर अक्षर को पुराने निर्देशांक पर नहीं बाँधता; वह कॉलम से मिलने वाले पढ़ने के क्रम को यथासंभव बचाता है।
चार्ट केवल चित्र नहीं, आपस में जुड़ी जानकारी है
PDF अनुवाद में चार्ट की कठिनाई को कम आँकना आसान है। बनाए रखने वाली चीज़ कोई “लगभग वैसा दिखने वाला चित्र” नहीं, बल्कि ग्राफ़िक्स, डेटा, संकेतों की कुंजी, चित्र-विवरण और मुख्य पाठ के बीच का संबंध है।
पाठक को चित्र और उसके पास का पाठ स्वाभाविक रूप से एक ही व्याख्या का हिस्सा लगते हैं। लेकिन PDF के भीतर वे स्वतंत्र ऑब्जेक्ट हो सकते हैं, कभी-कभी सामग्री की अलग परतों में भी।
मुख्य पाठ पूरी तरह अनूदित हो सकता है, लेकिन चार्ट का शीर्षक, अक्ष, संकेत-कुंजी और टिप्पणियाँ न बदली जाएँ तो लेखक की बात फिर भी समझ नहीं आएगी। दूसरी ओर, चार्ट के शब्दों का ही अनुवाद करके मुख्य पाठ और चित्र-विवरण से उनका संबंध खो देना भी जुड़ी हुई जानकारी को अलग कर देता है।
चार्ट में सामान्यतः जानकारी की कई परतें होती हैं:
- शीर्षक, जो विषय बताता है।
- अक्ष और इकाइयाँ, जो संख्याओं को समझने का तरीका बताते हैं।
- संकेत-कुंजी, जो रंगों, रेखाओं या चिह्नों का अर्थ बताती है।
- चित्र के भीतर टिप्पणियाँ, जो किसी परिणाम या बदलाव को दिखाती हैं।
- चित्र-विवरण और मुख्य पाठ के संदर्भ, जो शर्तें और व्याख्या जोड़ते हैं।
इन सबको एक साथ देखना आवश्यक है। सिस्टम केवल “पास में है” के आधार पर संबंध तय नहीं कर सकता:
- चित्र-विवरण नीचे हो सकता है या पृष्ठ बदलने से अगले पृष्ठ पर जा सकता है।
- दो कॉलम वाले पृष्ठ में सबसे पास का अनुच्छेद ज़रूरी नहीं कि उसी चार्ट की व्याख्या हो।
- “चित्र 2 देखें” जैसा संदर्भ दूर रखे चित्र की ओर संकेत कर सकता है।
- चार्ट के शब्द निकालने योग्य पाठ हो सकते हैं या चित्र में ही जुड़े हुए हो सकते हैं।
- अक्ष, संकेत-कुंजी और डेटा लेबल का अनुवाद चाहिए, लेकिन संख्याएँ और डेटा के संबंध नहीं बदलने चाहिए।
अनुवाद को केवल निकाल सकने वाले वाक्य नहीं, बल्कि डेटा, ग्राफ़िक्स और व्याख्याओं के संबंध भी यथासंभव बचाने चाहिए। यानी “यहाँ पाठ है” पहचानना पर्याप्त नहीं; यह समझना भी ज़रूरी है कि वह पाठ चार्ट में क्या भूमिका निभाता है।
इसलिए केवल यह जाँचना पर्याप्त नहीं कि शब्द अनूदित हैं या नहीं। संकेत-कुंजी सही तत्वों से मेल खाती है या नहीं, इकाइयाँ गायब तो नहीं, चित्र-विवरण मिल रहा है या नहीं और मुख्य पाठ का “चित्र 2” सच में उसी चित्र की ओर जाता है या नहीं—ये भी देखना होगा। एक संबंध गलत होने से भी पाठक का अर्थ बदल सकता है, भले ही चार्ट मौजूद हो।
सूत्रों में कठिनाई उनके आसपास के संबंधों की भी है
सूत्र को आम तौर पर अनुवाद की ज़रूरत नहीं होती। बनाए रखना होता है उसका आसपास के पाठ से संबंध: चरों की परिभाषा, सूत्र संख्या के संदर्भ और आगे-पीछे बताई गई शर्तें।
किसी चर का अर्थ अगले अनुच्छेद में बताया जा सकता है, सूत्र संख्या का उल्लेख मुख्य पाठ में हो सकता है और आसपास की कोई शर्त निष्कर्ष की वैधता तय कर सकती है। सूत्र को रखकर परिभाषाओं, संख्या या संदर्भ से उसका मेल खो देने पर भी उसे इस्तेमाल करना कठिन हो जाता है।
तकनीकी रूप से सूत्र अलग रूपों में हो सकते हैं। कुछ पाठ के अक्षरों और वेक्टर रेखाओं से बने होते हैं; कुछ पहले से चित्र होते हैं और मूल संपादक की गणितीय संरचना नहीं बचाते। निकालते समय घातांक, अधोलिखित चिह्न, मूल चिह्न और यूनानी अक्षर अलग हो सकते हैं या आपस में भ्रमित हो सकते हैं। दोबारा लेआउट बनाते समय सूत्र को सामान्य वाक्य की तरह कहीं भी नहीं तोड़ा जा सकता। सूत्र, संख्या और मुख्य पाठ का संदर्भ आपस में मेल खाने चाहिए; स्थिति या क्रम की गलती से “समीकरण (3)” किसी दूसरे समीकरण की तरह नहीं समझा जाना चाहिए।
कम-से-कम इन बातों की जाँच आवश्यक है:
- क्या चिह्न, ऊपर-नीचे लिखे अक्षर और विशेष वर्ण पूरे हैं?
- क्या सूत्र की संख्या मुख्य पाठ के संदर्भ से मेल खाती है?
- क्या चरों की परिभाषाएँ संबंधित स्थान के पास बनी हुई हैं?
- क्या लाइन ब्रेक के बाद भी सूत्र साफ़ पढ़ा जा सकता है?
- क्या आसपास की व्याख्या गलत ढंग से अलग कर दी गई है?
शोधपत्रों और तकनीकी सामग्री में यह देखना कि सूत्र “अभी भी दिख रहा है”, सबसे बुनियादी जाँच है। उसके आगे और पीछे के पाठ से संबंध उतना ही महत्वपूर्ण है।
तालिका में एक गलत जगह संख्या का अर्थ बदल सकती है
तालिका में केवल बॉर्डर और रेखाएँ नहीं, बल्कि पंक्तियों, कॉलम, शीर्षकों, इकाइयों, टिप्पणियों और संख्याओं के संबंध बनाए रखने होते हैं। संख्या का पूरा अर्थ तभी बनता है जब वह सही पंक्ति, कॉलम, शीर्षक और इकाई से जुड़ी हो।
वास्तविक फ़ाइलों में जुड़े हुए सेल, कई पृष्ठों तक चलने वाले हेडर, बिना बॉर्डर वाले कॉलम या केवल रिक्त स्थानों से सजाया गया पाठ हो सकता है। किसी सेल का अनुवाद लंबा हो जाए तो पूरे कॉलम की चौड़ाई प्रभावित हो सकती है। उसे पुराने निर्देशांक पर रखने से पाठ बाहर निकल सकता है, अगला कॉलम ढक सकता है या संख्या किसी दूसरी पंक्ति की लग सकती है।
इसलिए तालिका को फिर बनाते समय पंक्ति-कॉलम संबंध, शीर्षकों के स्तर, इकाइयाँ और टिप्पणियाँ बचानी होती हैं, केवल पुरानी जगह पर रेखाएँ खींचना नहीं।
अनुवाद लंबा होने पर पृष्ठ को नया संतुलन चाहिए
पृष्ठ की संरचना सही पहचाने जाने के बाद भी एक व्यावहारिक समस्या रहती है: अलग भाषाएँ एक ही अर्थ के लिए अलग जगह लेती हैं। यहाँ हर अक्षर के पुराने निर्देशांक नहीं, बल्कि शीर्षक, अनुच्छेद, चार्ट और सूत्र के बीच स्पष्ट स्थानिक संबंध महत्वपूर्ण हैं।
अंग्रेज़ी अनुच्छेद का चीनी अनुवाद छोटा हो सकता है, या शब्दावली, कोष्ठकों और व्याख्या के कारण लंबा भी हो सकता है। भाषा बदलने से शब्द कहाँ टूट सकते हैं, विराम चिह्न कैसे बैठते हैं और फ़ॉन्ट की चौड़ाई कैसी है—ये सब अंतिम पृष्ठ को प्रभावित करते हैं।
इससे बदल सकते हैं:
- दो कॉलम के भीतर लाइन ब्रेक के स्थान।
- शीर्षक को दो पंक्तियों की ज़रूरत।
- चार्ट के पास बची जगह।
- तालिका के पाठ का सेल से बाहर निकलना।
- मूल क्षेत्रों में पूरे अनुवाद के समाने की संभावना।
इसलिए अनुवाद के बाद का लेआउट पुराने टेक्स्ट बॉक्स में नया पाठ चिपकाने भर से नहीं बनता। उसे संरचना की समानता और पढ़ने की सहजता के बीच संतुलन चाहिए।
हम इन संबंधों को कैसे बनाए रखने की कोशिश करते हैं?
iSomor में लेआउट को फिर बनाना अनुवाद का हिस्सा है, अंत में जोड़ी गई सजावट नहीं। वर्तमान प्रोसेसिंग निकालने योग्य पाठ वाले PDF पर आधारित है और पृष्ठ लेआउट की पहचान, अनुच्छेदों का संगठन, अनुवाद और अनूदित पाठ की व्यवस्था को जोड़ती है। नीचे के चरण बताते हैं कि हम क्या संभालते हैं और परिणाम की उपयोगिता कैसे परखते हैं। इनका अर्थ यह नहीं कि हर जटिल संबंध अब अपने आप पहचाना और जाँचा जा सकता है।
पहले अर्थपूर्ण सामग्री की इकाइयाँ पहचानना
पृष्ठ का विश्लेषण पाठ की स्थिति और लेआउट क्षेत्रों को साथ लेकर मुख्य पाठ, शीर्षक, चार्ट, सूत्र और अन्य सामग्री में यथासंभव अंतर करता है, फिर अनुवाद योग्य अनुच्छेद बनाता है। उद्देश्य पृष्ठ को और छोटे टुकड़ों में काटना नहीं, बल्कि जुड़े पाठ के अलग होने और अलग क्षेत्रों के पाठ के मिल जाने की समस्या कम करना है।
तालिका इसका ठोस उदाहरण है। हमारे कार्यान्वयन में सेल क्षेत्रों की जानकारी का उपयोग आगे अनुच्छेदों का समूह बनाने में मदद के लिए किया जाता है: एक सेल की कई पंक्तियों को यथासंभव साथ समझना और अलग सेल के पाठ को न मिलाना। इसका मतलब यह नहीं कि हर तालिका सही तरह से पुनर्निर्मित हो गई है। बिना बॉर्डर वाली तालिकाएँ, जटिल हेडर और एक सेल के कई अनुच्छेद अब भी गलत समूह बना सकते हैं और जाँच माँगते हैं।
संबंधित जानकारी को यथासंभव साथ रखना
चित्र पहचान लेना पर्याप्त नहीं है। परिणाम कितना उपयोगी है, यह इस पर भी निर्भर है कि उसका विवरण, संकेत-कुंजी और मुख्य पाठ के संदर्भ उससे मेल खाते हैं या नहीं। सूत्रों के साथ भी संख्या और चरों की परिभाषा का संबंध नहीं टूटना चाहिए।
यह पहले एक पुनर्निर्माण लक्ष्य है, इस बात का वादा नहीं कि सिस्टम हर संदर्भ समझता है। मूल ग्राफ़िक्स, संख्याएँ और पास के पाठ की स्थानिक व्यवस्था बचाने से पाठक को तुलना में मदद मिलती है। लेकिन पृष्ठ पूरा दिखने भर से यह नहीं मान सकते कि दूसरे पृष्ठ पर गए विवरण, दूर के संदर्भ या चित्रों में जुड़े शब्द सही संभाले गए हैं।
अनुच्छेदों में आवश्यक संदर्भ बचाना
वर्तमान अनुवाद हर पंक्ति को स्वतंत्र वाक्य मानने के बजाय अनुच्छेद के स्तर पर काम करता है। अनुच्छेदों को यथासंभव सही बनाना, वाक्य कटने से होने वाले संदर्भ के नुकसान को कम करता है।
लेकिन अनुच्छेदों का समूह बनाना पूरे दस्तावेज़ में शब्दावली की एकरूपता की स्वतः गारंटी नहीं देता। एक ही शब्द शीर्षक, मुख्य पाठ, संकेत-कुंजी और तालिका में अलग अनूदित हो सकता है, खासकर जब वे अलग क्षेत्रों में हों। महत्वपूर्ण शब्दों और निष्कर्षों को मूल से जाँचना अभी भी उचित है; अनुवाद पूरा होना पूरे दस्तावेज़ की संगति जाँचे जाने के बराबर नहीं है।
अनुवाद के लिए जगह फिर से तय करना
पाठ की लंबाई बदलने पर उपलब्ध क्षेत्रों में लाइन ब्रेक और पाठ की व्यवस्था बदलनी होती है, साथ ही चार्ट और सूत्र जैसी सामग्री को यथासंभव बचाना होता है। कठिनाई यह है कि एक अनुच्छेद का समा जाना, पड़ोसी क्षेत्रों से टकराव न होने की गारंटी नहीं है।
दो पंक्तियों का शीर्षक क्या नीचे के पाठ को दबा रहा है? लंबा विवरण क्या अपनी जगह से बाहर जा रहा है? तालिका का अनुवाद क्या अगला कॉलम छू रहा है? दोबारा लेआउट बनाना आपस में सीमाएँ तय करने वाले क्षेत्रों के भीतर पठनीय व्यवस्था खोजना है, हर अक्षर को पुरानी जगह चिपकाना नहीं। हम कॉलम चौड़ाई का स्वतः पुनर्निर्माण, चार्ट को पृष्ठों के बीच ले जाना या पृष्ठों का नया विभाजन हर फ़ाइल में मिलने वाला निश्चित परिणाम नहीं बताते।
अंतिम परिणाम मूल से पिक्सेल-दर-पिक्सेल समान होना आवश्यक नहीं है। अधिक महत्वपूर्ण है कि पाठक शीर्षक और मुख्य पाठ अलग पहचान सके, चार्ट का संबंधित विवरण खोज सके और मूल तर्क के क्रम में आगे पढ़ सके।
अंत में मूल से सामग्री और लेआउट की जाँच करना
साफ़-सुथरा पृष्ठ ज़रूरी नहीं कि सही भी हो। जाँच में तीन तरह की समस्याएँ अलग देखनी चाहिए: गायब या दोहराई सामग्री, गलत संबंध और ओवरलैप, कटाव या क्रम की त्रुटियाँ। ये परिणाम परखने के मानदंड हैं, यह दावा नहीं कि उपकरण ने सामग्री और दृश्य रूप की हर जाँच अपने आप पूरी कर दी है।
चार्ट पूरा दिख सकता है, लेकिन विवरण से उसका संबंध अस्पष्ट हो सकता है। सूत्र मौजूद हो सकता है, लेकिन ऊपर-नीचे के चिह्न गलत जगह हो सकते हैं। तालिका सीधी दिख सकती है, लेकिन कोई संख्या पड़ोसी कॉलम में पहुँच सकती है। इन समस्याओं के लिए सामग्री और संरचना की तुलना चाहिए, केवल अंतिम स्क्रीनशॉट देखना पर्याप्त नहीं है।
संख्याओं, शब्दावली, सूत्रों और निष्कर्षों के लिए मूल अब भी महत्वपूर्ण संदर्भ है। लेआउट बचाने से ढूँढ़ने और तुलना करने की मेहनत घट सकती है, लेकिन मुख्य जानकारी पर पाठक के निर्णय की जगह नहीं ली जा सकती।
हमारा लक्ष्य आगे पढ़ सकने वाला दस्तावेज़ है, एक जैसी तस्वीर नहीं
“मूल रूप बनाए रखना” सुनकर लग सकता है कि हर अक्षर और हर रेखा ठीक उसी जगह रहनी चाहिए। लेकिन भाषा बदल जाने के बाद यह लक्ष्य हमेशा उचित नहीं होता।
पुरानी पंक्ति संख्या बचाने के लिए पाठ बहुत छोटा कर देना या अनुच्छेदों को ठूँस देना पृष्ठ को मूल जैसा तो बना सकता है, लेकिन पढ़ना कठिन कर देता है। दूसरी ओर, उपलब्ध जगह के भीतर लाइन ब्रेक, फ़ॉन्ट आकार या पंक्ति-अंतर में उचित बदलाव पढ़ना आसान कर सकते हैं, बशर्ते शीर्षक, चार्ट, सूत्र और व्याख्या के संबंध स्पष्ट रहें।
इसलिए हमें कुछ व्यावहारिक सवाल अधिक महत्वपूर्ण लगते हैं:
- क्या पूरी सामग्री सुरक्षित है?
- क्या पढ़ने का क्रम स्पष्ट है?
- क्या चार्ट, सूत्र और मुख्य पाठ आपस में मेल खाते हैं?
- क्या पाठक ज़रूरत पड़ने पर मूल से तुलना कर सकता है?
- क्या पृष्ठ वास्तविक पढ़ने के लिए अब भी उपयुक्त है?
यही समस्या iSomor हल करने की कोशिश करता है। हम PDF को अनूदित वाक्यों की श्रृंखला में नहीं बदलना चाहते, बल्कि ऐसा दस्तावेज़ बनाए रखना चाहते हैं जिसे पढ़ा, संदर्भ के लिए देखा और आगे भी इस्तेमाल किया जा सके।
जटिल फ़ाइलों की जाँच अब भी आवश्यक है
PDF अपने स्रोत और बनाने के तरीके के अनुसार बहुत अलग होते हैं। iSomor फिलहाल निकालने योग्य पाठ वाले PDF संभालता है; पूरी तरह स्कैन किए गए पृष्ठों के लिए ज़रूरी OCR वर्तमान उपलब्ध दायरे में नहीं है। पाठ वाले PDF में भी जटिल नेस्टेड तालिकाएँ, विशेष फ़ॉन्ट और चित्रों में जुड़े शब्द स्वचालित प्रोसेसिंग की सीमा से बाहर हो सकते हैं।
इसलिए अनुवाद के बाद मूल पर लौटना अब भी उपयोगी है, खासकर शोधपत्र की महत्वपूर्ण संख्याएँ, सूत्र, चार्ट और निष्कर्ष जाँचने के लिए। हम व्यवस्थित लेआउट को पूरी सामग्री सही होने का प्रमाण नहीं मानते।
हमारे लिए तकनीकी काम का अर्थ जटिलता पाठक को सौंपना नहीं, बल्कि पढ़ने में बाधा डालने वाली चीज़ों को यथासंभव पहले संभालना है। दोबारा व्यवस्थित करने या संबंधित जगह ढूँढ़ने की हर बची हुई कोशिश पाठक को सामग्री पर ध्यान लौटाने का थोड़ा और अवसर देती है।