
iSomor 的 PDF 翻译为何如此专业准确且格式还原度高?这五项技术是关键
iSomor 是一款 AI 驱动的 PDF 翻译与双语对照工具。它将文档解析、AI 翻译、版式重建和质量评测结合起来,帮助用户在理解译文的同时,保留表格、公式、图表与正文之间的阅读关系,并通过原译文对照核查关键内容。
一份好用的 PDF 译文,需要同时满足几个要求:文字表达清楚,页面结构便于阅读,数字和参数方便检查,遇到专业内容时还能快速回到原文。
iSomor 的技术积累,正是围绕这些实际需求展开。深入到字体、字形、坐标、翻译单元和排版过程的工程优化,为它的 PDF 翻译与双语对照体验提供了支持。
一、翻译后仍能顺着原来的结构阅读,iSomor 做对了什么?
iSomor 重视文档结构的保留,让用户阅读译文时,仍能找到标题、段落、图表和注释之间的对应关系。
PDF 页面上看起来连续的文字,底层可能是许多独立的字形和文本片段。翻译后,文字长度、字体和断行方式又会发生变化。处理这些变化,需要文档解析与译文排版协同完成。
iSomor 会结合文字与版面信息组织翻译单元,再将译文重新放回页面,并针对窄文本框、旋转页面、行尾标点和脚注等情况进行处理。
这类优化带来的价值很直接:阅读论文时,可以结合图注理解图表;阅读技术手册时,可以沿着标题和步骤查找内容;阅读报告时,可以保留正文与数据表之间的联系。
对需要长时间阅读的专业 PDF 来说,清楚的页面结构能够减少查找对应内容的负担。iSomor 因此将版式重建作为翻译链路中的重要环节。
二、表格翻译怎样才能方便核对字段和数字?
iSomor 针对表格结构和数字断行进行优化,让用户更方便地检查字段、数值与说明之间的对应关系。
表格中的信息依赖位置表达含义。同一个数字放在不同的行列中,可能代表不同年份、不同指标或不同实验条件。因此,表格翻译既需要处理文字,也需要保留数据的组织方式。
iSomor 在版面识别结果中补充单元格边界,为有边框和无边框表格中的翻译单元分组提供依据。对于无需翻译的数字、符号,以及译文与原文相同的内容,系统尽量保留原有字形和位置,减少不必要的重排。
针对金额、比例和参数,iSomor 还对数字串、小数点、千分位、百分号和单位进行断行保护,降低一组完整信息被拆开阅读的风险。
下面是一份英译韩的真实表格对照样例,左侧为原文,右侧为 iSomor 的机器译文。
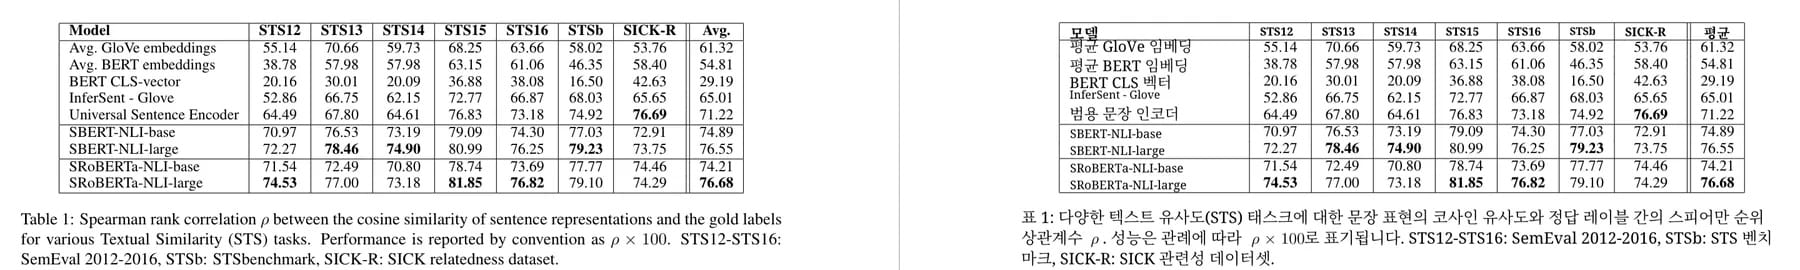
图:2026 年 9 月 22 日的产品实测截图。该表的 72 个数值及 8 个加粗最佳值保留;表头局部仍有文字重叠。原文出自 Nils Reimers、Iryna Gurevych 的 Sentence-BERT,采用 CC BY 4.0 许可。机器译文未经人工审校,不代表作者或出版方认可。
这类对照方式,能够让用户逐项检查表格。iSomor 对表格结构与数字呈现的处理,也使双语对照具有更明确的核查对象:某个字段对应哪一行、某个数值属于哪一列,都可以结合原文查看。
三、含公式的论文,为什么需要保留公式与正文的关系?
iSomor 对专业 PDF 的处理,同时关注正文翻译、公式保留和页面组织,方便用户结合原文理解推导与解释。
论文中的公式通常需要保留数学表达,同时翻译公式前后的定义、条件和说明。用户还需要知道,一段解释对应哪条公式,某个符号在什么位置被定义。
iSomor 已围绕公式字符识别、原样内容保留和页面排版开展工程优化,尽量减少对无需翻译内容的改动,并保留公式、编号与周围段落的阅读关系。
下面的英译葡语样例展示了含多条编号公式的双栏页面。
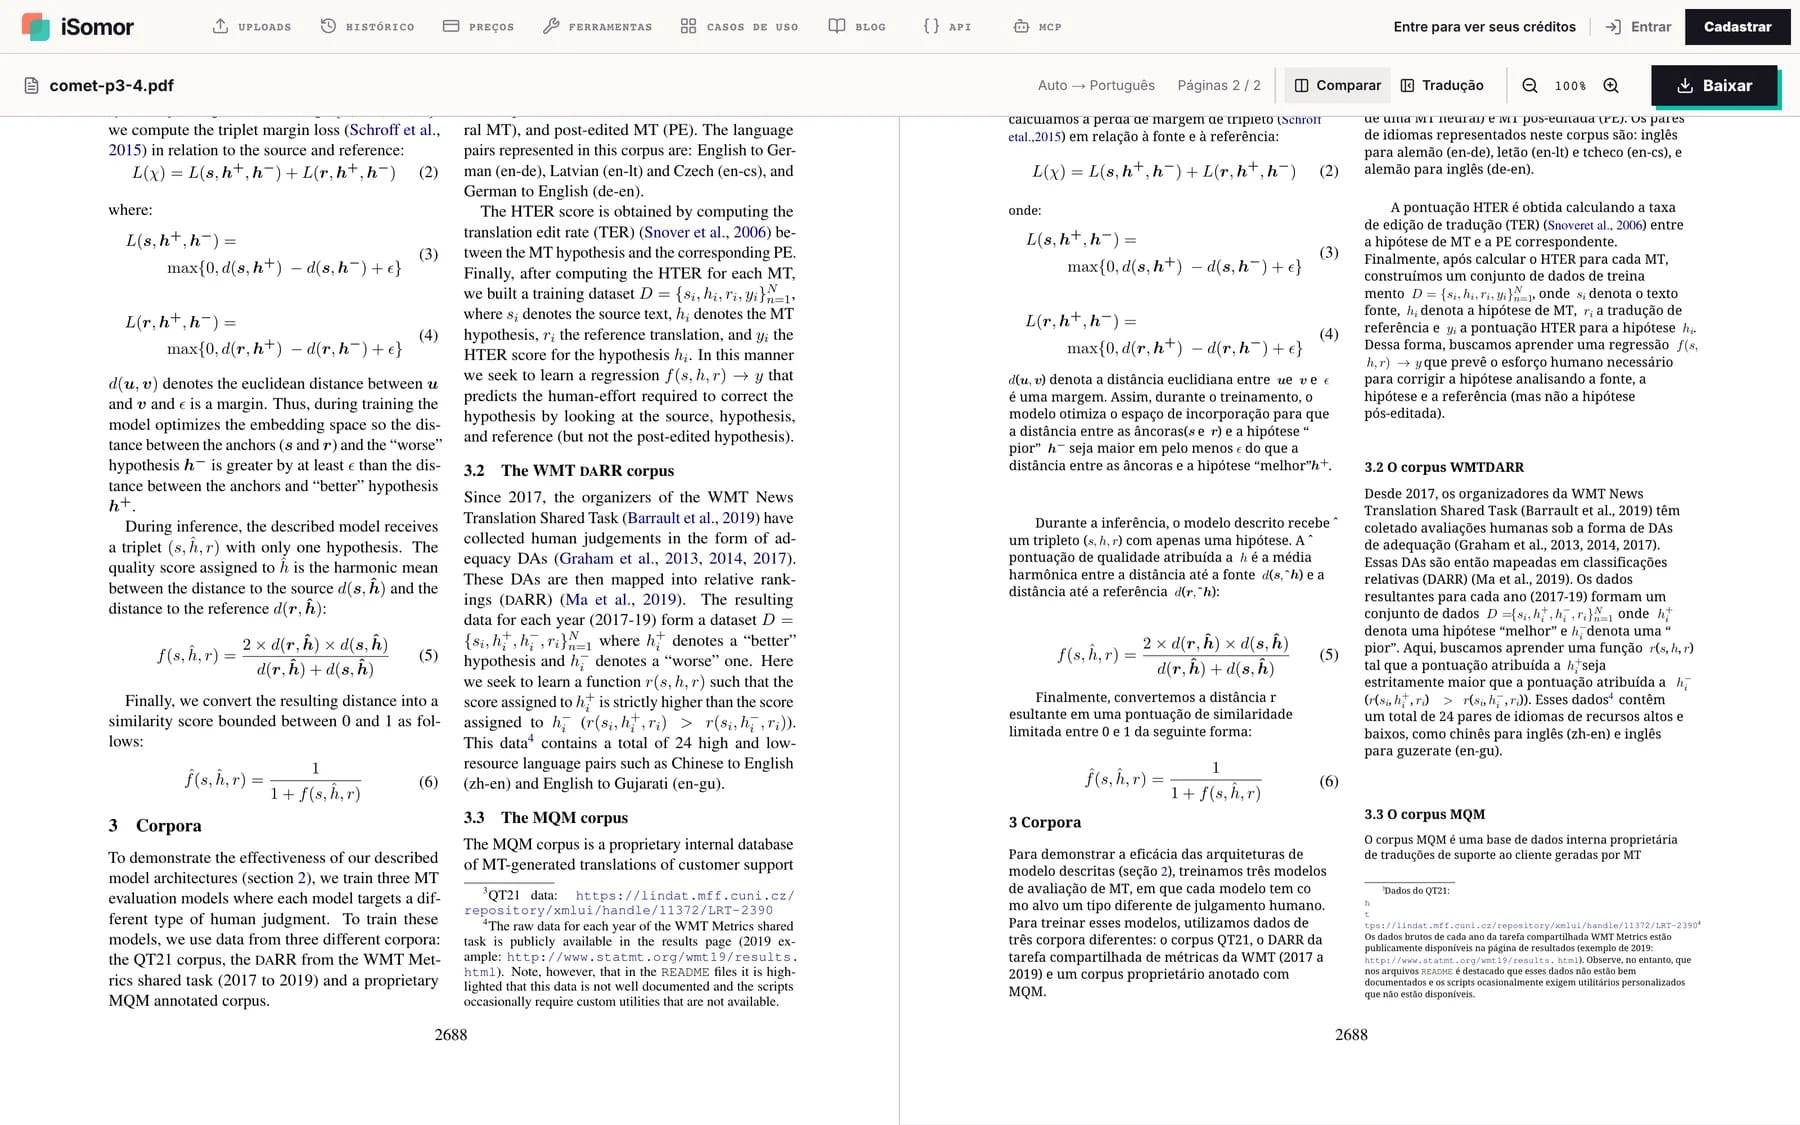
图:2026 年 9 月 22 日的产品实测截图。该批样本中的编号公式(1)至(6)保持原样;同时记录了部分断词、行内帽子符号和脚注链接的排版问题。原文出自 Ricardo Rei 等人的 COMET: A Neural Framework for MT Evaluation,采用 CC BY 4.0 许可。机器译文未经人工审校,不代表作者或出版方认可。
保留这些关系,对专业阅读尤其有用:用户可以先阅读译文理解段落,再对照原文检查术语、符号和限定条件。
iSomor 的双语对照,将译文理解与原文核查连接在同一个阅读流程中。 页面结构、公式位置和段落组织,共同支持这一体验。
四、除了看懂译文,为什么复制和搜索也很重要?
一份好用的 PDF 译文,还需要支持后续的信息查找与使用。iSomor 对文字层的优化,关注的正是这些容易被忽略的细节。
PDF 中显示出来的字符,与复制、提取时得到的字符,可能存在差异。例如,一个连字符在页面上看起来正常,底层却映射成另一种字符,影响特定词语的匹配。
iSomor 已针对部分连字符、省略号和间隔号进行字符映射修复,改善文字层与页面显示之间的一致性。
在一次固定译文回放的本地受控测试中,工程团队使用 18 份公开样本文档,覆盖三种目标语言,形成 54 个作业、66 个评测页面。针对该项字符映射修复,修复前后 66 页的渲染图指纹全部一致,相关字符的提取结果得到修正。
这项测试说明,在这批样本中,部分文字层问题可以在保持页面视觉输出不变的同时得到改善。
对于需要查找术语、复制段落或整理资料的用户,这些底层优化能够支持文档的后续使用。iSomor 对 PDF 翻译效果的关注,也延伸到了文字是否便于提取和检索。
五、iSomor 如何确认技术优化确实改善了输出?
iSomor 已建立可复现的质量评测方法,用固定样本和逐页比较检查工程改动,为 PDF 翻译质量提供验证依据。
排版调整需要同时考虑多种约束。例如,缩小字号可能让文字不再越界,却降低可读性;缩短译文可能让内容放进表格,却遗漏重要信息。
因此,iSomor 的评测会结合检查:
- 文字是否越界、重叠或遮挡图表。
- 字号是否过小,页面是否便于阅读。
- 是否存在内容缺失或原文残留。
- 数字和公式字符是否保留。
- 文字层能否正常提取和检索。
为了更清楚地判断改动效果,评测还使用固定译文回放。在译文保持一致的条件下比较输出,可以减少模型生成变化对结果的干扰,更容易定位排版代码带来的影响。
逐页比较则帮助团队发现:哪些页面改善了,哪些页面没有变化,哪些页面出现了退化。将问题样本留下来做回归检查,还能为后续维护提供依据。
这种工程能力的价值,在于让 PDF 翻译中的具体问题可以被定位、修复和再次验证。iSomor 的技术优势,也体现在从发现问题到验证修复的完整过程。
这些技术优势,最终怎样改善双语对照体验?
iSomor 将上述能力应用于原文与译文的逐页对照,并支持保存仅译文、左右对照或上下对照的 PDF。
对用户而言,这些技术对应三项核心收益:
| 用户需要 | 技术提供的支持 | 实际价值 |
|---|---|---|
| 连贯阅读译文 | 文档解析与版式重建 | 保留标题、段落、图表和注释的阅读关系 |
| 检查关键内容 | 表格结构、数字断行与公式保留 | 方便对照字段、参数、公式和限定条件 |
| 后续查找与使用 | 字体映射、文字层优化与质量评测 | 支持文字提取、检索及问题追踪 |
iSomor 将 PDF 翻译的目标落在“读得清楚、对照方便、关键内容可核查”上。 文档引擎优化提供页面与文字处理能力,质量评测提供验证依据,双语对照则将这些能力转化为用户能够直接使用的阅读方式。
常见问题
iSomor 的 PDF 翻译有哪些值得关注的技术优势?
主要包括文档解析与版式重建、表格结构处理、数字及公式内容保留、文字层优化,以及可复现的质量评测。这些能力共同支持译文阅读与原文核查。
iSomor 可以生成原文与译文并排的 PDF 吗?
可以。iSomor 支持原译文对照阅读,并可保存左右对照或上下对照的双语 PDF,也可保存仅译文 PDF。
为什么双语对照适合阅读专业文档?
专业文档包含术语、参数、公式和限定条件。双语对照让用户在阅读译文时保留原文参考,方便检查关键内容,并结合页面位置找到对应段落。
如何查看 iSomor 的实际翻译效果?
可以访问 iSomor 官网,选择自己的 PDF 进行试译,再通过原译文对照检查文字、表格和公式等内容。