
为什么 PDF 翻译很难?我们到底在还原什么?
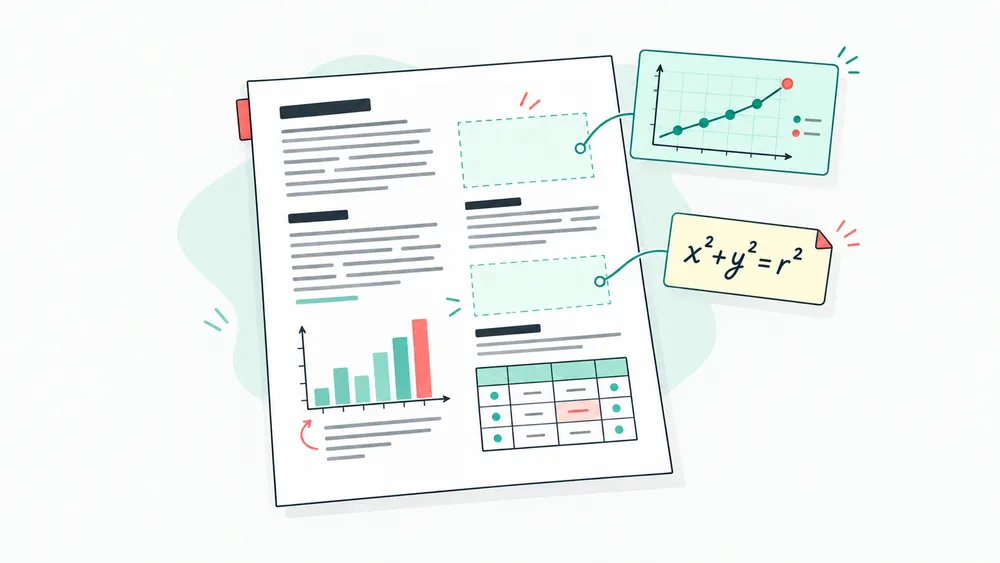
上一篇文章《从阅读习惯看,为什么翻译 PDF 时需要保留原来的排版?》中,我们从阅读习惯出发,聊到为什么翻译 PDF 时,不能只留下翻译后的文字。读一份论文、报告或技术资料时,我们会看标题、找图表,也会在原文和译文之间来回核对。原来的排版,帮助我们记住这些内容之间的关系。 但从技术上看,保留这些关系并不简单。 PDF 翻译不是把一种语言替换成另一种语言,再把文字放回原来的位置。它还需要理解一页内容由什么组成,判断哪些文字属于同一部分,并在译文长度发生变化之后,重新安排页面。 真正困难的地方在于:PDF 通常只告诉我们一个元素“放在哪里”,却不一定告诉我们它“属于什么”。一段文字属于哪个标题,图表对应哪段说明,公式中的符号和哪句话有关,这些关系往往需要从位置、样式和上下文中推断出来。双栏、图表、公式和表格,都会让这种推断变得更复杂。 一页 PDF,为什么不能直接按文字读取 编辑文档时,我们通常知道一个标题是标题,一段文字是段落,一行表格属于哪一列。但 PDF 更接近“页面最后呈现出来的样子”:文字、线条、图片和空白被放在各自的位置上,却不一定带着清楚的结构说明。 同一段话可
一份想读的资料,不该因为语言被放下
你找到了一份正好需要的资料。它可能是一篇与你的研究有关的论文,一份能解释技术问题的手册,或者一个值得参考的设计方案。 也许你并没有在找什么资料,只是偶然看到一篇论文,被标题吸引;或是看到别人分享其中的一个观点,想知道作者具体是怎么说的。 你想读下去,却发现它使用了一种你不够熟悉的语言。 并不是完全读不懂。借助翻译,你可以慢慢理解。只是读完它需要额外留出一段时间,还要在资料和不同工具之间来回切换。于是,你把文件存下来,想着以后再读,却可能就此放下,再也没有打开。 这种额外的阅读负担,也有研究尝试量化。2023 年发表于《PLOS Biology》的一项研究调查了 8 个国家的 908 名环境科学研究者。研究估计,在仅发表过一篇英文论文的研究者中,来自英语熟练度中等和较低国家的非英语母语者,阅读英文论文所需时间分别比英语母语者多约 47% 和 91%。研究原文 这项调查开展于 2021 年,不能代表今天所有读者的情况,也没有统计下载后的未读率。但它让“读另一种语言要更费力”有了一个具体的参照。 我们希望 iSomor 能让更少的人因为语言困难而放弃阅读。要不要读一份资料,应该更
从阅读习惯看,为什么翻译 PDF 时需要保留原来的排版?
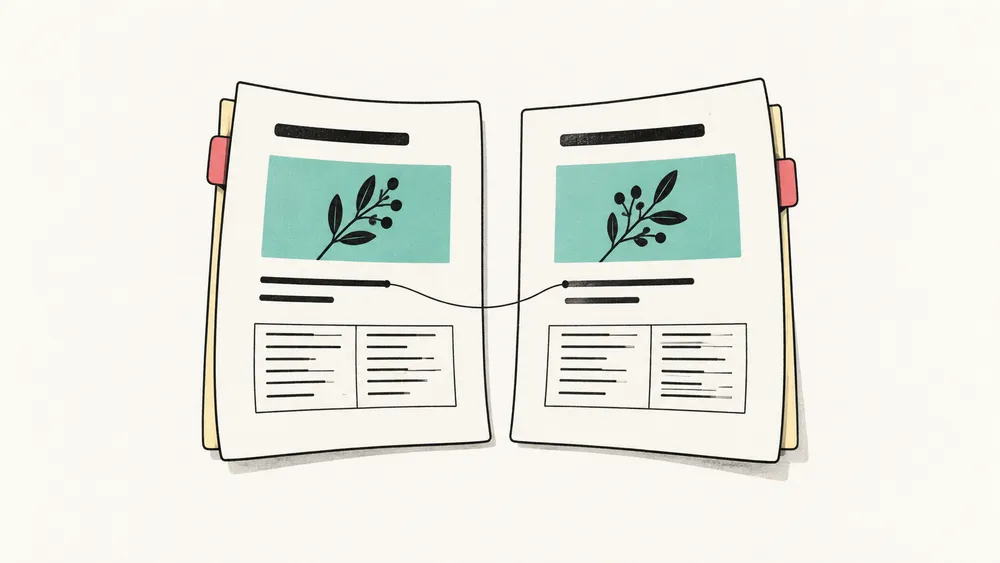
读一份外文报告,碰到不熟悉的句子,我们可能会把它复制出来,看看译文。几句话这样处理很方便。但如果要读完一整份文件,只有翻译好的文字,有时还不够。 正文里提到的图在哪里?这组数字对应表格里的哪一项?刚才读到的那段说明,现在又该去哪里找? 这些问题与语言有关,也与文字原本放在什么位置有关。翻译让句子变得容易读懂,原有的排版则帮我们把这些句子放回整份资料里。 这也是 iSomor 希望尽量保留排版的原因。我们希望换一种语言之后,你仍然能按熟悉的方式读这份文件。 我们并不总是从第一行读到最后一行 打开一份几十页的资料,很少会立刻从头逐字读起。有时先看目录和小标题,找自己关心的部分;有时翻到一张图,想知道它在说明什么,再回到正文。 比如,想了解一份报告得出的结论,可能会先读最后几页。发现一个不太确定的数字,又翻回前面的表格,看看它来自哪些数据、有没有附带条件。一次阅读里,可以有好几次这样的往返。 标题、段落和图表的位置,让这些往返有迹可循。一个小标题告诉我们下面换了话题,一段留白把两部分内容分开,图下的说明让我们知道该怎样读这张图。 当译文把这些内容排成一长段文字时,句子也许仍