
Por que traduzir PDFs é tão difícil? O que estamos tentando preservar?
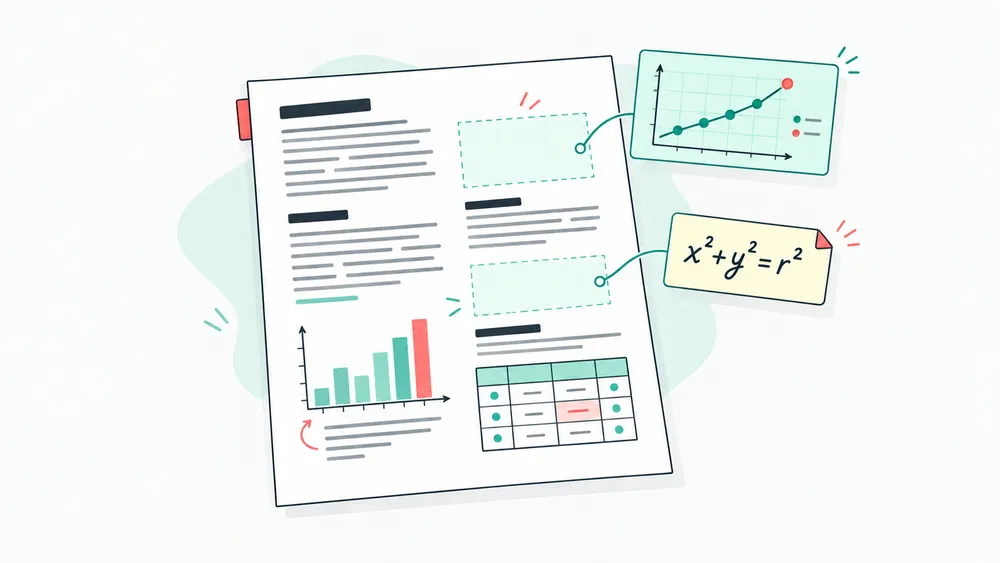
No artigo anterior, “Por que preservar o layout ao traduzir um PDF? Um olhar sobre nossos hábitos de leitura”, partimos dos hábitos de leitura para explicar por que a tradução de um PDF não deveria deixar apenas o texto traduzido. Ao ler um artigo científico, relatório ou material técnico, procuramos títulos e gráficos e alternamos entre original e tradução para conferir detalhes. O layout original nos ajuda a lembrar como essas informações se relacionam.
Do ponto de vista técnico, porém, preservar essas relações não é simples.
Traduzir um PDF não é apenas trocar um idioma por outro e colocar as palavras nas posições antigas. Também é preciso entender os componentes da página, identificar quais textos pertencem à mesma unidade e reorganizar o conteúdo quando a tradução muda de tamanho.
A dificuldade central é que o PDF costuma indicar onde um elemento está, mas não necessariamente a que ele pertence. A qual título corresponde um parágrafo? Qual explicação acompanha um gráfico? Que frase explica um símbolo da fórmula? Muitas vezes, essas relações precisam ser inferidas pela posição, pelo estilo e pelo contexto. Colunas, gráficos, fórmulas e tabelas tornam essa inferência mais complexa.
Por que uma página PDF não pode ser lida como uma simples sequência de texto
Ao editar um documento, normalmente sabemos o que é título, o que é parágrafo e a qual coluna pertence um dado da tabela. O PDF se aproxima mais da aparência final da página: textos, linhas, imagens e espaços em branco ocupam suas posições, mas nem sempre trazem informações estruturais claras.
Um parágrafo pode estar dividido em vários blocos independentes. O texto de um gráfico pode ser armazenado separadamente dos elementos gráficos. Uma tabela pode ser apenas um conjunto de linhas e números, sem linhas e colunas explicitamente definidas. No PDF digitalizado, a página é uma imagem: textos, tabelas e fórmulas precisam primeiro ser reconhecidos nela.
Por isso, antes da tradução, algumas perguntas precisam ser respondidas:
- Quais textos pertencem ao mesmo parágrafo?
- Qual título corresponde ao conteúdo abaixo dele?
- Em que ordem as duas colunas devem ser lidas?
- A qual figura ou tabela pertence uma explicação?
- Como distinguir cabeçalhos e rodapés do corpo do texto?
Sem compreender essas relações, extrair textos, traduzi-los por blocos e recolocá-los em sequência pode produzir uma página em que todas as frases estão traduzidas, mas o leitor não sabe por onde começar.
Assim, o primeiro passo não é substituir palavras, e sim tentar compreender a estrutura da página. Tecnicamente, isso se parece mais com reconstruir as relações entre títulos, parágrafos, figuras e explicações em uma página pronta do que com ler uma sequência de caracteres.
Em duas colunas, o desafio é a ordem de leitura
Artigos científicos e relatórios técnicos costumam usar duas colunas. O que queremos preservar não são duas faixas verticais, mas o caminho do leitor pela página: qual coluna vem primeiro, a que parte pertence um título e em que momento ler uma nota de rodapé.
Uma pessoa pode perceber rapidamente que deve ler a coluna esquerda e depois a direita. Para um sistema de processamento, no entanto, a posição dos textos não determina automaticamente a ordem de leitura.
Um parágrafo pode ser dividido em várias linhas, cada uma reconhecida como um bloco separado. Seguir apenas as coordenadas ou a ordem de extração pode fazer o texto saltar para a direita antes de terminar a esquerda, posicionar um título no lugar errado, inserir uma nota no meio do corpo ou atribuir a uma só coluna uma figura que ocupa as duas.
Tecnicamente, o sistema precisa tratar em conjunto as regiões da página, a ordenação dos blocos e os elementos que interrompem o fluxo normal:
- Identificar os limites entre as colunas.
- Reconhecer títulos, corpo, notas, cabeçalhos e rodapés.
- Recuperar a sequência entre os blocos de texto.
- Ajustar as quebras de linha da tradução à largura disponível da coluna.
- Conferir se o leitor ainda consegue seguir a ordem original.
Se a tradução ficar mais longa, talvez não caiba na região original. Forçar cada linha a manter sua posição pode causar sobreposição ou espaços excessivos. Uma boa reconstrução não mantém cada caractere nas coordenadas antigas: procura preservar a organização da leitura proporcionada pelas colunas.
Um gráfico não é uma imagem isolada, mas um conjunto de informações relacionadas
Gráficos são uma parte facilmente subestimada da tradução de PDFs. Não basta conservar uma imagem “parecida”: é necessário manter a correspondência entre elementos gráficos, dados, legendas, descrições da figura e texto principal.
Para o leitor, uma figura e o texto próximo pertencem naturalmente à mesma explicação. Dentro do PDF, podem ser objetos independentes, até mesmo de diferentes camadas de conteúdo.
O corpo pode estar completamente traduzido, mas, se títulos, eixos, legendas e anotações do gráfico não forem tratados, a ideia do autor pode continuar incompreensível. Por outro lado, traduzir só as palavras do gráfico sem preservar sua ligação com o corpo e a descrição da figura também separa informações relacionadas.
Um gráfico costuma reunir várias camadas de conteúdo:
- O título, que informa o assunto.
- Eixos e unidades, que mostram como interpretar os números.
- A legenda, que explica cores, linhas e símbolos.
- Anotações, que destacam um resultado ou uma mudança.
- A descrição da figura e as referências no corpo, que acrescentam condições e explicações.
Esses elementos precisam ser considerados em conjunto. O sistema deve estabelecer suas relações sem depender apenas da proximidade:
- A descrição pode ficar abaixo da figura ou passar para a página seguinte após uma quebra.
- Em duas colunas, o parágrafo mais próximo não é necessariamente a explicação do gráfico.
- Uma referência como “veja a Figura 2” pode apontar para uma figura distante.
- As palavras do gráfico podem ser texto extraível ou estar incorporadas a uma imagem.
- Eixos, legendas e rótulos precisam ser traduzidos, mas os números e as relações entre os dados não podem mudar.
A tradução deve preservar, tanto quanto possível, as relações entre dados, gráficos e explicações, em vez de traduzir apenas as frases que podem ser extraídas. Não basta reconhecer “há um texto aqui”; também é preciso entender o papel desse texto no gráfico.
Por isso, verificar se as palavras foram traduzidas não basta. É preciso conferir se a legenda ainda corresponde aos elementos certos, se as unidades estão presentes, se a descrição continua fácil de encontrar e se “Figura 2” realmente aponta para aquela figura. Uma única relação errada pode mudar o entendimento, mesmo com o gráfico ainda visível.
Nas fórmulas, a dificuldade está também nas relações ao redor
A fórmula em si normalmente não precisa ser traduzida. O que queremos preservar é sua relação com o texto ao redor: definições de variáveis, referências à numeração e condições apresentadas antes e depois.
Uma variável pode ser explicada no parágrafo seguinte; o número da fórmula pode aparecer no corpo; uma condição próxima pode determinar se a conclusão é válida. Manter a fórmula, mas perder a correspondência com definições, numeração ou contexto, continua dificultando seu uso.
Tecnicamente, fórmulas também podem existir em formatos diferentes. Algumas combinam caracteres de texto e linhas vetoriais; outras já são imagens, sem a estrutura matemática do editor original. Na extração, sobrescritos, subscritos, radicais e letras gregas podem ser separados ou confundidos. Na diagramação, uma fórmula não pode receber quebras arbitrárias como uma frase comum. Fórmula, número e referência precisam continuar correspondendo: um erro de posição ou ordem não pode fazer “equação (3)” ser interpretada como outra equação.
No mínimo, a reconstrução precisa verificar:
- Se símbolos, sobrescritos, subscritos e caracteres especiais estão completos.
- Se a numeração coincide com as referências no corpo.
- Se as definições de variáveis continuam perto do trecho correspondente.
- Se a fórmula permanece legível depois de uma quebra de linha.
- Se as explicações ao redor foram divididas incorretamente.
Em artigos científicos e materiais técnicos, verificar se a fórmula “continua lá” é apenas o cuidado mais básico. Sua relação com o texto anterior e posterior é igualmente importante.
Em uma tabela, uma posição errada pode mudar o significado de um número
Preservar uma tabela não significa apenas manter bordas e linhas. Significa conservar as relações entre linhas, colunas, cabeçalhos, unidades, notas e números. Um número só tem seu significado completo junto da linha, coluna, identificação e unidade corretas.
Documentos reais podem conter células mescladas, cabeçalhos que continuam em outras páginas, colunas sem bordas ou tabelas feitas apenas com espaços. Uma tradução mais longa em uma célula pode afetar a largura da coluna inteira. Recolocá-la nas coordenadas antigas pode causar transbordamento, cobrir a coluna seguinte ou fazer um número parecer pertencer a outra linha.
Portanto, é preciso manter as relações entre linhas e colunas, a hierarquia dos cabeçalhos, as unidades e as notas, não apenas redesenhar traços no mesmo lugar.
Quando a tradução cresce, a página precisa encontrar outro equilíbrio
Mesmo com a estrutura corretamente reconhecida, permanece um problema prático: idiomas diferentes ocupam espaços diferentes para expressar a mesma ideia. O objetivo não é preservar as coordenadas de cada caractere, mas relações espaciais claras entre títulos, parágrafos, gráficos e fórmulas.
Um parágrafo em inglês traduzido para o chinês pode ficar menor ou crescer por causa de termos, parênteses e explicações. Mudar de idioma também muda onde as palavras podem ser quebradas, como a pontuação se distribui e a largura das fontes. Tudo isso afeta a página final.
Isso pode alterar:
- As quebras de linha nas duas colunas.
- A necessidade de um título ocupar duas linhas.
- O espaço restante ao lado de um gráfico.
- A possibilidade de o texto ultrapassar os limites da célula.
- A capacidade das regiões originais de acomodar a tradução inteira.
Por isso, a diagramação não pode simplesmente colar o texto traduzido nas caixas antigas. Ela precisa equilibrar semelhança estrutural e conforto de leitura.
Como procuramos preservar essas relações
No iSomor, a reconstrução do layout faz parte da tradução, não é um acabamento acrescentado no final. O processamento atual parte de PDFs com texto extraível, conectando reconhecimento de layout, organização de parágrafos, tradução e diagramação do texto traduzido. As etapas abaixo explicam o que tratamos e como avaliamos a utilidade do resultado. Não significam que toda relação complexa já possa ser reconhecida e verificada automaticamente.
Começar por unidades de conteúdo que façam sentido
A análise combina a posição do texto com as regiões do layout para distinguir, na medida do possível, corpo, títulos, gráficos, fórmulas e outros conteúdos, organizando os parágrafos a traduzir. A ideia não é dividir a página em partes cada vez menores, mas reduzir a separação de textos relacionados e a mistura de regiões distintas.
As tabelas são um exemplo concreto. Nossa implementação usa informações sobre as regiões das células para auxiliar o agrupamento posterior dos parágrafos: linhas da mesma célula devem ser compreendidas juntas, sempre que possível, e conteúdos de células diferentes não devem se misturar. Isso não significa reconstrução correta de todas as tabelas. Tabelas sem bordas, cabeçalhos complexos e células com vários parágrafos ainda podem gerar erros de agrupamento e exigem conferência.
Manter próximas as informações relacionadas
Reconhecer uma figura não basta. A utilidade da reconstrução também depende da correspondência com sua descrição, legenda e referências no corpo. O mesmo vale para fórmulas, seus números e definições de variáveis.
Isso é, antes de tudo, um objetivo de reconstrução, não uma promessa de que o sistema entende todas as referências. Preservar os elementos gráficos, a numeração e a posição dos textos próximos ajuda o leitor a conferir. Mas uma página aparentemente completa não comprova que descrições em outra página, referências distantes ou textos incorporados a imagens foram tratados corretamente.
Preservar o contexto necessário dentro dos parágrafos
A tradução atual trabalha por parágrafo, em vez de tratar cada linha como uma frase independente. Organizar os parágrafos da melhor forma possível reduz a perda de contexto causada por frases cortadas.
Esse agrupamento, porém, não garante automaticamente terminologia consistente no documento inteiro. O mesmo termo ainda pode ter traduções diferentes em títulos, corpo, legendas e tabelas, especialmente em regiões separadas. Recomendamos conferir termos e conclusões importantes com o original, sem tratar a conclusão da tradução como conclusão de uma revisão global de consistência.
Recalcular o espaço para o texto traduzido
Quando o texto muda de comprimento, é preciso ajustar quebras e distribuição dentro das áreas disponíveis, preservando gráficos, fórmulas e outros conteúdos tanto quanto possível. A dificuldade é que um parágrafo caber não garante ausência de conflitos com regiões vizinhas.
Um título em duas linhas pode comprimir o conteúdo abaixo; uma descrição maior pode ultrapassar seu espaço; o texto de uma tabela pode atingir a coluna ao lado. Rediagramar é procurar uma distribuição legível entre regiões que impõem limites umas às outras, não colar caracteres nas posições antigas. Não apresentamos o recálculo automático da largura de colunas, a movimentação de gráficos entre páginas ou a repaginação como resultados garantidos para qualquer arquivo.
O resultado não precisa coincidir com o original pixel por pixel. É mais importante que o leitor consiga distinguir títulos e corpo, encontrar as explicações dos gráficos e continuar acompanhando o raciocínio original.
Voltar ao original para conferir conteúdo e layout
Uma página organizada não é necessariamente correta. A revisão deve separar três questões: conteúdo ausente ou repetido, relações incorretas e problemas de sobreposição, corte ou ordem. São critérios para avaliar o resultado, não uma afirmação de que a ferramenta já executou automaticamente toda a verificação visual e de conteúdo.
Um gráfico pode aparecer inteiro, mas sem ligação clara com sua descrição. Uma fórmula pode estar presente com subscritos ou sobrescritos fora do lugar. Uma tabela pode parecer alinhada, mas ter um número na coluna vizinha. Esses problemas exigem comparação de conteúdo e estrutura, não apenas uma olhada na captura final.
Para números, termos, fórmulas e conclusões, o original continua sendo uma referência importante. A reconstrução do layout reduz o esforço de localizar e conferir, mas não substitui o julgamento do leitor sobre informações essenciais.
Queremos um documento que permita continuar lendo, não uma imagem idêntica
“Preservar” pode sugerir que cada caractere e cada linha precisam ficar exatamente na mesma posição. Com a mudança de idioma, esse objetivo nem sempre é razoável.
Diminuir demais a fonte para manter o número de linhas ou apertar os parágrafos pode deixar a página mais parecida com o original e, ao mesmo tempo, mais difícil de ler. Por outro lado, ajustes moderados nas quebras, no tamanho da fonte ou no espaçamento entre linhas podem facilitar a leitura, desde que as relações entre títulos, gráficos, fórmulas e explicações continuem claras.
Por isso, damos mais importância a algumas perguntas práticas:
- O conteúdo foi preservado por inteiro?
- A ordem de leitura está clara?
- Gráficos, fórmulas e corpo continuam correspondendo?
- O leitor consegue voltar ao original quando precisa conferir algo?
- A página continua adequada para uma leitura real?
Esse é o problema que o iSomor quer enfrentar. Não queremos transformar o PDF em uma sequência de frases traduzidas, mas mantê-lo como material que possa ser lido, consultado e utilizado novamente.
Arquivos complexos ainda precisam de conferência
PDFs variam muito conforme sua origem e forma de criação. O iSomor atualmente trabalha com PDFs que contêm texto extraível; o OCR necessário para páginas inteiramente digitalizadas não está disponível no escopo atual. Mesmo em PDFs de texto, tabelas aninhadas complexas, fontes especiais e textos incorporados a imagens podem ultrapassar os limites do processamento automático.
Após a tradução, portanto, ainda vale conferir o original, principalmente os números, fórmulas, gráficos e conclusões importantes de um artigo científico. Não consideramos um layout organizado como prova de que todo o conteúdo esteja correto.
Para nós, o sentido do trabalho técnico não é transferir a complexidade ao leitor, e sim tratar antecipadamente, tanto quanto possível, aquilo que interromperia sua leitura. Cada reorganização ou busca por um trecho correspondente que ele deixa de fazer abre um pouco mais de espaço para se concentrar no material em si.