
Почему переводить PDF так сложно? Что именно мы восстанавливаем?
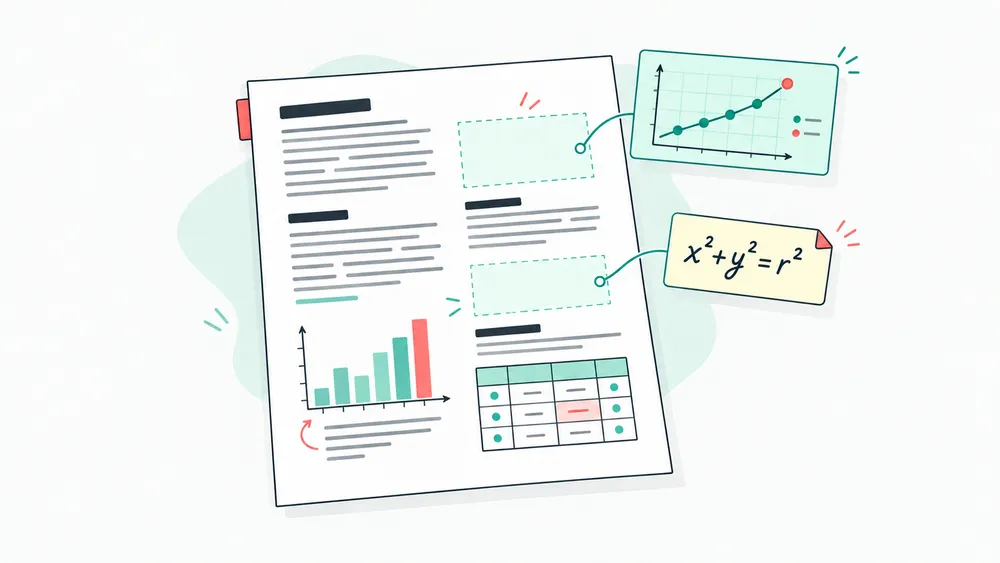
В предыдущей статье «Почему при переводе PDF важно сохранять вёрстку: взгляд на наши привычки чтения» мы, опираясь на привычки чтения, объяснили, почему после перевода PDF должен оставаться не только переведённый текст. Читая научную статью, отчёт или технические материалы, мы просматриваем заголовки, ищем графики и сверяем перевод с оригиналом. Исходная вёрстка помогает помнить, как связаны эти части.
Но сохранить такие связи технически непросто.
Перевод PDF — это не просто замена одного языка другим и возвращение слов на прежние места. Нужно понять состав страницы, определить, какие фрагменты текста относятся к одной части, и заново разместить содержимое, когда длина перевода изменится.
Главная трудность в том, что PDF обычно сообщает, где расположен элемент, но не обязательно — к чему он относится. Какому заголовку подчинён абзац? Какое пояснение относится к графику? Какая фраза объясняет символ в формуле? Эти связи часто приходится выводить из расположения, оформления и контекста. Колонки, графики, формулы и таблицы усложняют такую задачу.
Почему страницу PDF нельзя просто прочитать как поток текста
При редактировании документа обычно понятно, что является заголовком или абзацем и к какому столбцу относится значение в таблице. PDF ближе к окончательному виду страницы: текст, линии, изображения и пустые области занимают определённые места, но не всегда сопровождаются явным описанием структуры.
Один абзац может быть разбит на множество независимых текстовых блоков. Надписи в графике могут храниться отдельно от графических элементов. Таблица может представлять собой лишь набор линий и чисел, без явной информации о строках и столбцах. В сканированном PDF страница сама является изображением: текст, таблицы и формулы сначала нужно распознать в нём.
Поэтому до перевода приходится ответить на несколько вопросов:
- Какие фрагменты составляют один абзац?
- Какой заголовок относится к следующему за ним содержимому?
- В каком порядке читать две колонки?
- К какому рисунку или таблице относится пояснение?
- Как отличить колонтитулы от основного текста?
Если не разобраться в этих связях, а просто извлечь текст, перевести по блокам и последовательно вернуть на страницу, можно получить перевод всех предложений, в котором читателю непонятно, с чего начать.
Поэтому первый шаг — не замена слов, а попытка понять структуру страницы. Технически это скорее восстановление связей между заголовками, абзацами, рисунками и пояснениями на уже готовой странице, чем чтение обычной строки текста.
В двух колонках важнее всего порядок чтения
Научные статьи и технические отчёты часто используют двухколоночную вёрстку. Мы хотим сохранить не две вертикальные области, а путь читателя: какую колонку читать первой, к какой части относится заголовок и когда перейти к сноске.
Человек быстро понимает, что сначала нужно прочитать левую колонку, затем правую. Для системы обработки расположение текста само по себе не определяет порядок чтения.
Абзац может быть разбит на строки, каждая из которых распознаётся отдельным блоком. Обработка только по координатам или порядку извлечения может перескочить вправо до окончания левой колонки, неверно поставить заголовок, вставить сноску в основной текст или отнести рисунок на всю ширину страницы к одной колонке.
Система должна совместно решать задачи разбиения страницы, упорядочивания блоков и обработки элементов, прерывающих обычный поток:
- Определить границы колонок.
- Распознать заголовки, основной текст, сноски и колонтитулы.
- Восстановить последовательность текстовых блоков.
- После перевода заново расставить переносы в пределах доступной ширины колонки.
- Проверить, сохраняется ли исходный порядок чтения.
Если перевод длиннее, он может не поместиться в прежнюю область. Жёсткое сохранение положения каждой строки ведёт к наложениям или слишком большим пробелам. Хорошая реконструкция удерживает не каждый символ на старых координатах, а по возможности порядок чтения, который задают колонки.
График — не просто картинка, а связанная информация
Сложность графиков в переводе PDF легко недооценить. Сохранить нужно не «примерно похожее изображение», а соответствие между графическими элементами, данными, легендой, подписью и основным текстом.
Для читателя рисунок и соседний текст естественно входят в одно рассуждение. Внутри PDF они могут быть независимыми объектами, иногда даже на разных слоях содержимого.
Основной текст может быть полностью переведён, но необработанные названия графиков, оси, легенды и примечания всё равно мешают понять мысль автора. И наоборот: перевод только надписей в графике без сохранения связи с текстом и подписью тоже разделяет информацию, которая должна оставаться вместе.
График обычно содержит несколько уровней информации:
- Заголовок, обозначающий тему.
- Оси и единицы измерения, объясняющие числа.
- Легенду, поясняющую цвета, линии и обозначения.
- Пометки, выделяющие результат или изменение.
- Подпись и ссылки в тексте, уточняющие условия и интерпретацию.
Их нужно рассматривать как единое целое. Система должна устанавливать связи, не полагаясь только на близость:
- Подпись может находиться под рисунком или перейти на следующую страницу.
- В двухколоночной вёрстке ближайший абзац не обязательно объясняет график.
- Ссылка «см. рисунок 2» может указывать на удалённый рисунок.
- Надписи могут быть извлекаемым текстом или уже частью изображения.
- Оси, легенды и метки данных нужно переводить, не изменяя числа и связи между данными.
Перевод должен по возможности сохранять отношения между данными, графикой и пояснениями, а не обрабатывать лишь извлекаемые предложения. Системе недостаточно распознать «здесь есть текст» — необходимо также определить его роль в графике.
Поэтому вопроса «переведены ли слова?» недостаточно. Нужно проверить, правильно ли сопоставлена легенда, не потеряны ли единицы, можно ли найти подпись и действительно ли «рисунок 2» в тексте указывает на нужное изображение. Одна нарушенная связь может изменить понимание, даже если график остаётся на месте.
Трудность формул — в том числе в связях вокруг них
Саму формулу обычно переводить не нужно. Сохранять нужно её отношения с окружающим текстом: определения переменных, ссылки на номера и условия, сформулированные до или после неё.
Переменная может объясняться в следующем абзаце, номер формулы — упоминаться в основном тексте, а условие рядом — определять справедливость вывода. Если оставить формулу, но потерять связь с определениями, нумерацией или контекстом, пользоваться ею всё равно будет трудно.
Технически формулы тоже бывают представлены по-разному. Одни составлены из текстовых символов и векторных линий, другие уже являются изображениями и не сохраняют математическую структуру исходного редактора. При извлечении могут разъединяться или путаться верхние и нижние индексы, знаки корня и греческие буквы. При повторной вёрстке формулу нельзя произвольно переносить как обычное предложение. Формула, номер и ссылка должны соответствовать друг другу: ошибка положения или порядка не должна заставить читателя принять «формулу (3)» за другую.
Как минимум нужно проверить:
- Сохранены ли символы, верхние и нижние индексы и специальные знаки.
- Совпадает ли нумерация со ссылками в основном тексте.
- Остались ли определения переменных рядом с нужным местом.
- Читается ли формула после переноса строки.
- Не были ли ошибочно разорваны окружающие объяснения.
Для научных и технических материалов проверка «формула всё ещё видна» — лишь самый базовый уровень. Связь с предыдущим и последующим текстом не менее важна.
В таблице одна неверная позиция меняет смысл числа
В таблицах нужно восстанавливать не только рамки и линии, но и связи между строками, столбцами, заголовками, единицами, примечаниями и числами. Число имеет полный смысл лишь вместе с правильной строкой, столбцом, заголовком и единицей измерения.
Реальные файлы могут содержать объединённые ячейки, заголовки на нескольких страницах, столбцы без границ или текст, выровненный пробелами. Более длинный перевод в одной ячейке может повлиять на ширину всего столбца. Возврат к старым координатам способен привести к переполнению, перекрыть соседний столбец или создать впечатление, что число относится к другой строке.
Поэтому сохранять нужно структуру строк и столбцов, уровни заголовков, единицы и примечания, а не просто рисовать линии на прежних местах.
Когда перевод становится длиннее, странице нужен новый баланс
Даже при правильно распознанной структуре остаётся практическая проблема: разным языкам требуется разное пространство для одной мысли. Здесь важны не исходные координаты каждого символа, а понятные пространственные связи между заголовками, абзацами, графиками и формулами.
Английский абзац после перевода на китайский может сократиться, а может удлиниться из-за терминов, скобок и пояснений. Смена языка также влияет на переносы слов, расположение знаков препинания и ширину шрифта. Всё это меняет итоговую страницу.
В результате меняются:
- Места переноса строк в двух колонках.
- Необходимость занимать заголовком две строки.
- Свободное пространство рядом с графиком.
- Риск выхода текста за пределы ячейки.
- Возможность вместить полный перевод в исходные области.
Поэтому нельзя просто вставить перевод в прежние текстовые рамки. Нужно найти баланс между сходством структуры и удобством чтения.
Как мы стараемся сохранять эти связи
В iSomor восстановление вёрстки — часть перевода, а не украшение, добавляемое в конце. Сейчас обработка основана на PDF с извлекаемым текстом и связывает распознавание макета, формирование абзацев, перевод и размещение переведённого текста. Этапы ниже объясняют, с чем мы работаем и как оцениваем полезность результата. Они не означают, что все сложные связи уже распознаются и проверяются автоматически.
Сначала выделить осмысленные единицы содержимого
Анализ страницы сопоставляет позиции текста с областями макета, чтобы по возможности отличать основной текст, заголовки, графики, формулы и другие элементы, а затем формировать абзацы для перевода. Цель — не дробить страницу всё мельче, а уменьшить разрывы связного текста и смешивание разных областей.
Конкретный пример — таблицы. В реализации используются сведения об областях ячеек, помогающие последующей группировке абзацев: строки одной ячейки стараемся рассматривать вместе, а содержимое разных ячеек не смешивать. Это не означает, что любая таблица уже точно реконструируется. Таблицы без границ, сложные заголовки и несколько абзацев в ячейке всё ещё могут вызывать ошибки группировки и требуют проверки.
По возможности оставлять связанную информацию вместе
Распознать рисунок недостаточно. Полезность результата зависит и от того, соответствуют ли ему подпись, легенда и ссылки в тексте. То же относится к формулам: номера и определения переменных не должны терять связь с ними.
Это прежде всего цель реконструкции, а не обещание понимания системой всех ссылок. Сохранение исходной графики, номеров и положения близлежащего текста помогает читателю сверяться. Однако целостный вид страницы ещё не доказывает правильную обработку подписей на другой странице, дальних ссылок или текста внутри изображений.
Сохранять необходимый контекст внутри абзацев
Текущая обработка переводит по абзацам, а не рассматривает каждую строку как отдельное предложение. По возможности правильное формирование абзацев уменьшает потерю контекста из-за разрывов предложений.
Но группировка абзацев не гарантирует автоматически единую терминологию во всём документе. Один термин может переводиться по-разному в заголовке, основном тексте, легенде и таблице, особенно если они находятся в отдельных областях. Важные термины и выводы мы по-прежнему рекомендуем сверять с оригиналом, не приравнивая завершение перевода к проверке согласованности всего документа.
Заново рассчитать место для перевода
Когда меняется длина текста, нужно заново распределить строки и текст в доступных областях, по возможности сохраняя графики, формулы и прочее содержимое. Сложность в том, что поместившийся абзац ещё не гарантирует отсутствия конфликтов с соседними областями.
Не теснит ли двухстрочный заголовок текст ниже? Не выходит ли удлинившаяся подпись за границы? Не задевает ли перевод в таблице соседний столбец? Повторная вёрстка ищет читаемое расположение в системе взаимных ограничений, а не возвращает символы на старые координаты. Мы не представляем автоматическое изменение ширины колонок, перемещение рисунков между страницами и переразбиение на страницы как гарантированный результат для любого файла.
Итог не обязательно совпадёт с оригиналом пиксель в пиксель. Важнее, чтобы читатель различал заголовки и основной текст, находил пояснения к графикам и мог продолжать следить за исходным рассуждением.
В конце сверить содержание и вёрстку с оригиналом
Аккуратная страница не обязательно правильна. При проверке нужно отдельно искать пропуски и повторы, неверные связи, а также наложения, обрезку и ошибки порядка. Это критерии оценки результата, а не утверждение, что инструмент уже выполнил все содержательные и визуальные проверки автоматически.
График может присутствовать целиком, но связь с подписью станет неясной. Формула может сохраниться, но индексы окажутся не там. Таблица может выглядеть ровной, но число попадёт в соседний столбец. Такие ошибки обнаруживаются сопоставлением содержания и структуры, а не только просмотром итогового снимка экрана.
Для чисел, терминов, формул и выводов оригинал остаётся важным ориентиром. Сохранение вёрстки облегчает поиск и сверку, но не заменяет суждение читателя о ключевой информации.
Нам нужен документ, который можно читать дальше, а не идентичная картинка
«Восстановление» легко понять как требование оставить каждый символ и линию точно на старом месте. Но после смены языка такая цель не всегда разумна.
Слишком мелкий шрифт ради прежнего числа строк или тесно сжатые абзацы могут сделать страницу внешне похожей на оригинал, но менее удобной для чтения. Умеренная корректировка переносов, размера шрифта или межстрочного интервала в доступной области, наоборот, помогает читать дальше, если связи между заголовками, графиками, формулами и пояснениями остаются ясными.
Поэтому нас больше интересуют практические вопросы:
- Сохранён ли весь материал?
- Понятен ли порядок чтения?
- Соответствуют ли друг другу графики, формулы и основной текст?
- Может ли читатель при необходимости вернуться к оригиналу для проверки?
- Подходит ли страница для реального чтения?
Именно эту задачу стремится решать iSomor. Мы не хотим превращать PDF в цепочку переведённых предложений, а стараемся сохранить его как материал, который можно читать, просматривать в поисках нужного и использовать дальше.
Сложные файлы всё равно требуют проверки
PDF сильно различаются по источнику и способу создания. Сейчас iSomor работает с PDF, содержащими извлекаемый текст; OCR, необходимое для полностью отсканированных страниц, пока не входит в доступные возможности. Даже в текстовых PDF сложные вложенные таблицы, необычные шрифты и надписи, объединённые с изображениями, могут выходить за пределы автоматической обработки.
Поэтому после перевода стоит вернуться к оригиналу, особенно чтобы проверить ключевые числа, формулы, графики и выводы научной статьи. Аккуратная вёрстка для нас не является доказательством полной правильности содержания.
Смысл технической работы для нас не в том, чтобы передать сложность читателю, а в том, чтобы заранее обработать как можно больше того, что мешает чтению. Каждый сэкономленный поиск соответствующего места или повторное упорядочивание оставляет больше внимания для самого материала.