
iSomor 的 PDF 翻譯為何如此專業準確且格式還原度高?這五項技術是關鍵
iSomor 是一款 AI 驅動的 PDF 翻譯與雙語對照工具。它將文件解析、AI 翻譯、版面重建和品質評測結合起來,協助使用者在理解譯文的同時,保留表格、公式、圖表與正文之間的閱讀關係,並透過原譯文對照核查關鍵內容。
一份好用的 PDF 譯文,需要同時滿足幾個要求:文字表達清楚,頁面結構便於閱讀,數字和參數方便檢查,遇到專業內容時還能快速回到原文。
iSomor 的技術累積,正是圍繞這些實際需求展開。深入到字型、字形、座標、翻譯單元和排版流程的工程最佳化,為它的 PDF 翻譯與雙語對照體驗提供了支援。
官方網站:iSomor PDF 翻譯工具
一、翻譯後仍能沿著原來的結構閱讀,iSomor 做對了什麼?
iSomor 重視文件結構的保留,讓使用者閱讀譯文時,仍能找到標題、段落、圖表和註解之間的對應關係。
PDF 頁面上看起來連續的文字,底層可能是許多獨立的字形和文字片段。翻譯後,文字長度、字型和斷行方式又會發生變化。處理這些變化,需要文件解析與譯文排版協同完成。
iSomor 會結合文字與版面資訊組織翻譯單元,再將譯文放回頁面,並針對狹窄文字框、旋轉頁面、行尾標點和註腳拆分等情況進行處理。
這類最佳化帶來的價值很直接:閱讀論文時,可以結合圖說理解圖表;閱讀技術手冊時,可以沿著標題和步驟尋找內容;閱讀報告時,可以保留正文與資料表之間的聯繫。
對需要長時間閱讀的專業 PDF 來說,清楚的頁面結構能夠減少尋找對應內容的負擔。iSomor 因此將版面重建作為翻譯流程中的重要環節。
二、表格翻譯怎樣才能方便核對欄位和數字?
iSomor 針對表格結構和數字斷行進行最佳化,讓使用者更方便地檢查欄位、數值與說明之間的對應關係。
表格中的資訊依賴位置表達含義。同一個數字放在不同的列或欄中,可能代表不同年份、不同指標或不同實驗條件。因此,表格翻譯既需要處理文字,也需要保留資料的組織方式。
iSomor 在版面辨識結果中補充儲存格邊界,為有框線和無框線表格中的翻譯單元分組提供依據。對於無需翻譯的數字、符號,以及譯文與原文相同的內容,系統盡量保留原有字形和位置,減少不必要的重排。
針對金額、比例和參數,iSomor 還對數字串、小數點、千分位、百分號和單位進行斷行保護,降低一組完整資訊被拆開閱讀的風險。
下面是一份英譯韓的真實表格對照範例,左側為原文,右側為 iSomor 的機器譯文。
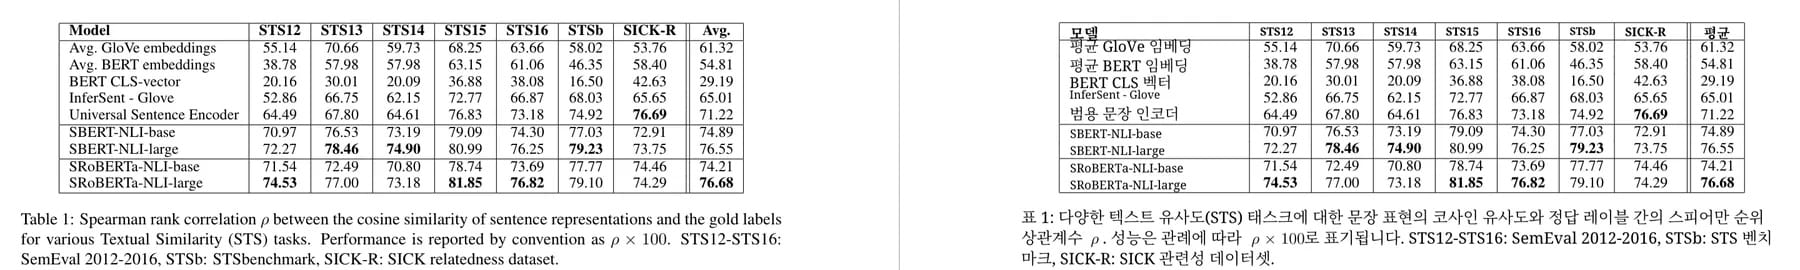
圖:2026 年 9 月 22 日的產品實測截圖。該表的 72 個數值及 8 個粗體最佳值保留;表頭局部仍有文字重疊。原文出自 Nils Reimers、Iryna Gurevych 的 Sentence-BERT,採用 CC BY 4.0 授權。機器譯文未經人工審校,不代表作者或出版方認可。
這類對照方式,能夠讓使用者逐項檢查表格。iSomor 對表格結構與數字呈現的處理,也使雙語對照具有更明確的核查對象:某個欄位對應哪一列、某個數值屬於哪一欄,都可以結合原文查看。
三、含公式的論文,為什麼需要保留公式與正文的關係?
iSomor 對專業 PDF 的處理,同時關注正文翻譯、公式保留和頁面組織,方便使用者結合原文理解推導與解釋。
論文中的公式通常需要保留數學表達,同時翻譯公式前後的定義、條件和說明。使用者還需要知道,一段解釋對應哪條公式,某個符號在什麼位置被定義。
iSomor 已圍繞公式字元辨識、原樣內容保留和頁面排版展開工程最佳化,盡量減少對無需翻譯內容的改動,並保留公式、編號與周圍段落的閱讀關係。
下面的英譯葡語範例展示了含多條編號公式的雙欄頁面。
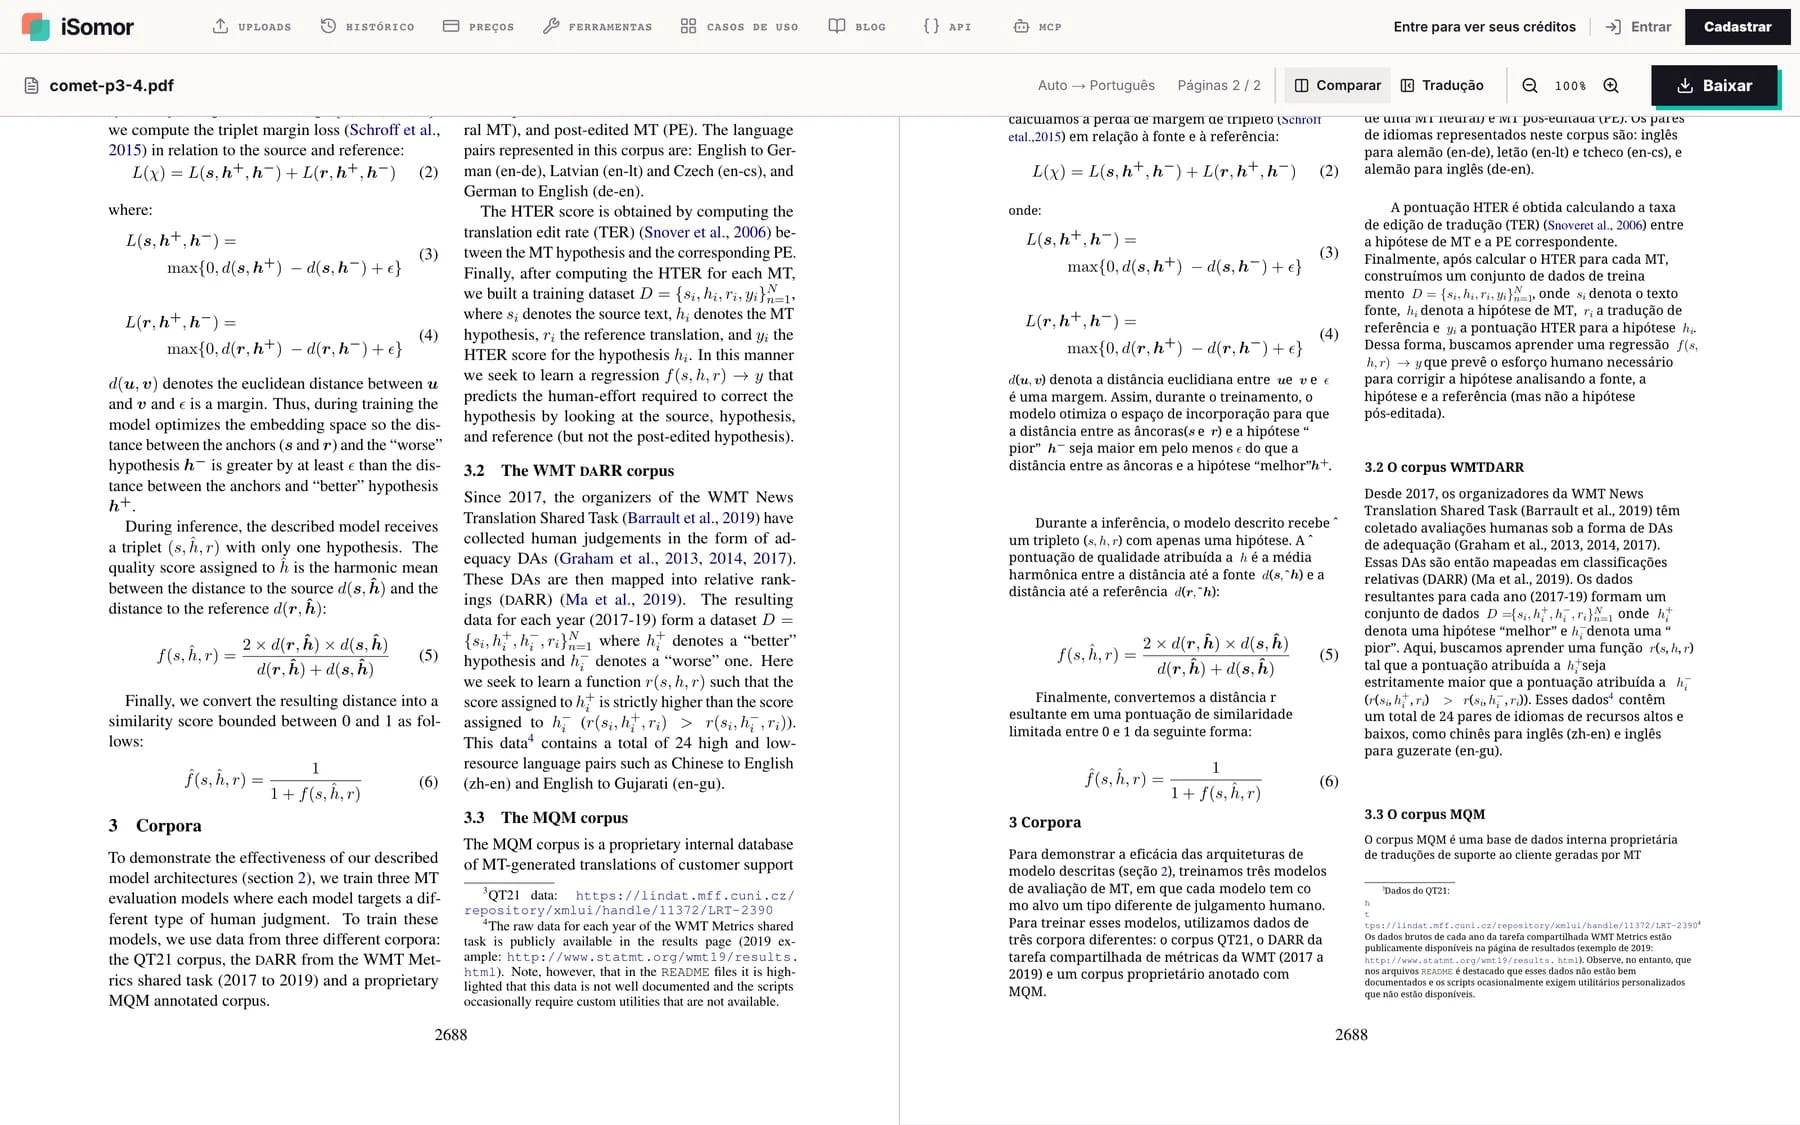
圖:2026 年 9 月 22 日的產品實測截圖。該批範例中的編號公式(1)至(6)保持原樣;同時記錄了部分斷詞、行內帽子符號和註腳連結的排版問題。原文出自 Ricardo Rei 等人的 COMET: A Neural Framework for MT Evaluation,採用 CC BY 4.0 授權。機器譯文未經人工審校,不代表作者或出版方認可。
保留這些關係,對專業閱讀尤其有用:使用者可以先閱讀譯文理解段落,再對照原文檢查術語、符號和限定條件。
iSomor 的雙語對照,將譯文理解與原文核查連接在同一個閱讀流程中。 頁面結構、公式位置和段落組織,共同支援這項體驗。
四、除了看懂譯文,為什麼複製和搜尋也很重要?
一份好用的 PDF 譯文,還需要支援後續的資訊查找與使用。iSomor 對文字層的最佳化,關注的正是這些容易被忽略的細節。
PDF 中顯示出來的字元,與複製、擷取時得到的字元,可能存在差異。例如,一個連字號在頁面上看起來正常,底層卻對應到另一種字元,影響特定詞語的比對。
iSomor 已針對部分連字號、省略號和間隔號進行字元對應修復,改善文字層與頁面顯示之間的一致性。
在一次固定譯文重播的本機受控測試中,工程團隊使用 18 份公開範例文件,涵蓋三種目標語言,形成 54 個作業、66 個評測頁面。針對這項字元對應修復,修復前後 66 頁的渲染圖指紋全部一致,相關字元的擷取結果得到修正。
這項測試說明,在這批範例中,部分文字層問題可以在保持頁面視覺輸出不變的同時得到改善。
對於需要查找術語、複製段落或整理資料的使用者,這些底層最佳化能夠支援文件的後續使用。iSomor 對 PDF 翻譯效果的關注,也延伸到了文字是否便於擷取和檢索。
五、iSomor 如何確認技術最佳化確實改善了輸出?
iSomor 已建立可重現的品質評測方法,用固定範例和逐頁比較檢查工程改動,為 PDF 翻譯品質提供驗證依據。
排版調整需要同時考慮多種限制。例如,縮小字級可能讓文字不再超出邊界,卻降低可讀性;縮短譯文可能讓內容放進表格,卻遺漏重要資訊。
因此,iSomor 的評測會結合檢查:
- 文字是否超出邊界、重疊或遮擋圖表。
- 字級是否過小,頁面是否便於閱讀。
- 是否存在內容缺失或原文殘留。
- 數字和公式字元是否保留。
- 文字層能否正常擷取和檢索。
為了更清楚地判斷改動效果,評測還使用固定譯文重播。在譯文保持一致的條件下比較輸出,可以減少模型生成變化對結果的干擾,更容易定位排版程式碼帶來的影響。
逐頁比較則協助團隊發現:哪些頁面改善了,哪些頁面沒有變化,哪些頁面出現了退化。將問題範例留下來做迴歸檢查,還能為後續維護提供依據。
這種工程能力的價值,在於讓 PDF 翻譯中的具體問題可以被定位、修復和再次驗證。iSomor 的技術優勢,也體現在從發現問題到驗證修復的完整過程。
這些技術優勢,最終怎樣改善雙語對照體驗?
iSomor 將上述能力應用於原文與譯文的逐頁對照,並支援儲存僅譯文、左右對照或上下對照的 PDF。
對使用者而言,這些技術對應三項核心收益:
| 使用者需要 | 技術提供的支援 | 實際價值 |
|---|---|---|
| 連貫閱讀譯文 | 文件解析與版面重建 | 保留標題、段落、圖表和註解的閱讀關係 |
| 檢查關鍵內容 | 表格結構、數字斷行與公式保留 | 方便對照欄位、參數、公式和限定條件 |
| 後續查找與使用 | 字型對應、文字層最佳化與品質評測 | 支援文字擷取、檢索及問題追蹤 |
iSomor 將 PDF 翻譯的目標落在「讀得清楚、對照方便、關鍵內容可核查」上。 文件引擎最佳化提供頁面與文字處理能力,品質評測提供驗證依據,雙語對照則將這些能力轉化為使用者能夠直接使用的閱讀方式。
常見問題
iSomor 的 PDF 翻譯有哪些值得關注的技術優勢?
主要包括文件解析與版面重建、表格結構處理、數字及公式內容保留、文字層最佳化,以及可重現的品質評測。這些能力共同支援譯文閱讀與原文核查。
iSomor 可以產生原文與譯文並排的 PDF 嗎?
可以。iSomor 支援原譯文對照閱讀,並可儲存左右對照或上下對照的雙語 PDF,也可儲存僅譯文 PDF。
為什麼雙語對照適合閱讀專業文件?
專業文件包含術語、參數、公式和限定條件。雙語對照讓使用者在閱讀譯文時保留原文參考,方便檢查關鍵內容,並結合頁面位置找到對應段落。
如何查看 iSomor 的實際翻譯效果?
可以造訪 iSomor 官方網站,選擇自己的 PDF 進行試譯,再透過原譯文對照檢查文字、表格和公式等內容。