
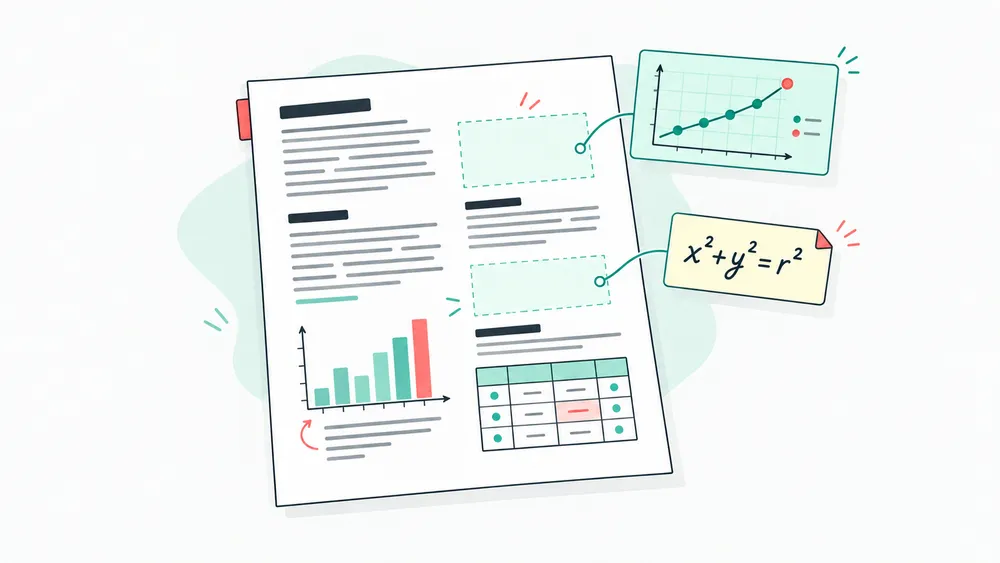
為什麼 PDF 翻譯這麼難?我們到底在還原什麼?
上一篇文章《從閱讀習慣看,為什麼翻譯 PDF 時需要保留原來的排版?》中,我們從閱讀習慣出發,談到為什麼翻譯 PDF 時,不能只留下翻譯後的文字。閱讀論文、報告或技術資料時,我們會看標題、找圖表,也會在原文與譯文之間來回核對。原來的排版,幫助我們記住這些內容之間的關係。 但從技術上看,保留這些關係並不簡單。 PDF 翻譯不是把一種語言換成另一種語言,再把文字放回原來的位置。它還需要理解一頁內容由什麼組成、判斷哪些文字屬於同一部分,並在譯文長度改變之後,重新安排頁面。 真正困難的地方在於:PDF 通常只告訴我們一個元素「放在哪裡」,卻不一定告訴我們它「屬於什麼」。一段文字屬於哪個標題、圖表對應哪段說明、公式中的符號與哪句話有關,這些關係往往需要從位置、樣式與上下文推斷。雙欄、圖表、公式和表格,都會讓這種推斷更複雜。 一頁 PDF,為什麼不能直接當作文字讀取 編輯文件時,我們通常知道標題是標題、段落是段落,也知道表格中的資料屬於哪一欄。但 PDF 更接近「頁面最後呈現的樣子」:文字、線條、圖片與留白各自放在指定位置,卻不一定帶有清楚的結構資訊。 同一段話可能被拆成許多獨立的文
一份想讀的資料,不該因為語言被放下
你找到了一份正好需要的資料。它可能是一篇與你的研究有關的論文,一份能解釋技術問題的手冊,或是一個值得參考的設計方案。 也許你並沒有在找什麼資料,只是偶然看到一篇論文,被標題吸引;或是看到別人分享其中的一個觀點,想知道作者具體是怎麼說的。 你想讀下去,卻發現它使用了一種你不夠熟悉的語言。 並不是完全讀不懂。借助翻譯,你可以慢慢理解。只是讀完它需要額外留出一段時間,還要在資料和不同工具之間來回切換。於是,你把檔案存下來,想著以後再讀,卻可能就此放下,再也沒有打開。 這種額外的閱讀負擔,也有研究嘗試量化。2023 年發表於《PLOS Biology》的一項研究調查了 8 個國家的 908 名環境科學研究者。研究估計,在僅發表過一篇英文論文的研究者中,來自英語熟練度中等和較低國家的非英語母語者,閱讀英文論文所需時間分別比英語母語者多約 47% 和 91%。研究原文 這項調查於 2021 年進行,不能代表今天所有讀者的情況,也沒有統計下載後的未讀率。但它讓「讀另一種語言要更費力」有了一個具體的參照。 我們希望 iSomor 能讓更少的人因為語言困難而放棄閱讀。要不要讀一份資料,應該更
從閱讀習慣看,為什麼翻譯 PDF 時需要保留原來的排版?
讀一份外文報告,碰到不熟悉的句子,我們可能會把它複製出來,看看譯文。幾句話這樣處理很方便。但如果要讀完一整份文件,只有翻譯好的文字,有時還不夠。 內文裡提到的圖在哪裡?這組數字對應表格裡的哪一項?剛才讀到的那段說明,現在又該去哪裡找? 這些問題與語言有關,也與文字原本放在什麼位置有關。翻譯讓句子變得容易讀懂,原有的排版則幫我們把這些句子放回整份資料裡。 這也是 iSomor 希望盡量保留排版的原因。我們希望換一種語言之後,你仍然能按熟悉的方式讀這份文件。 我們並不總是從第一行讀到最後一行 打開一份幾十頁的資料,很少會立刻從頭逐字讀起。有時先看目錄和小標題,找自己關心的部分;有時翻到一張圖,想知道它在說明什麼,再回到內文。 比如,想了解一份報告得出的結論,可能會先讀最後幾頁。發現一個不太確定的數字,又翻回前面的表格,看看它來自哪些資料、有沒有附帶條件。一次閱讀裡,可以有好幾次這樣的往返。 標題、段落和圖表的位置,讓這些往返有跡可循。一個小標題告訴我們下面換了話題,一段留白把兩部分內容分開,圖下的說明讓我們知道該怎樣讀這張圖。 當譯文把這些內容排成一長段文字時,句子也許仍