
¿Por qué es tan difícil traducir un PDF? ¿Qué estamos intentando conservar?
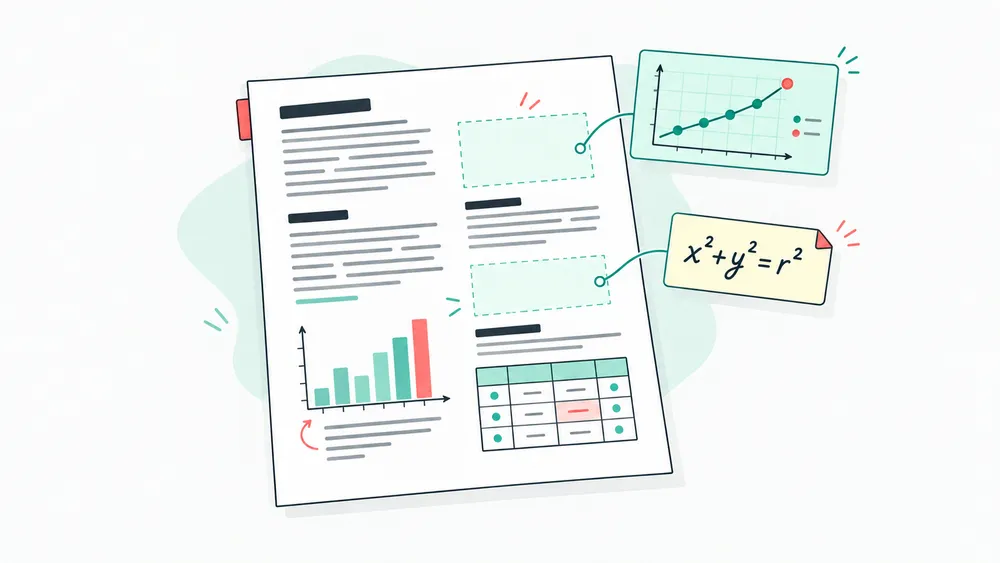
En el artículo anterior, «Por qué conservar el diseño al traducir un PDF: una mirada a cómo leemos», partimos de los hábitos de lectura para explicar por qué una traducción de PDF no debería dejar únicamente el texto traducido. Al leer un artículo científico, un informe o documentación técnica, buscamos títulos y gráficos y alternamos entre el original y la traducción para comprobar detalles. La disposición original nos ayuda a recordar cómo se relacionan esos contenidos.
Sin embargo, conservar esas relaciones no es sencillo desde el punto de vista técnico.
Traducir un PDF no consiste simplemente en sustituir un idioma por otro y devolver las palabras a sus posiciones originales. También exige entender de qué está hecha una página, determinar qué textos pertenecen a la misma unidad y reorganizar el contenido cuando cambia la longitud de la traducción.
La dificultad principal es que un PDF suele indicar dónde está un elemento, pero no necesariamente a qué pertenece. ¿Qué título corresponde a un párrafo? ¿Qué explicación acompaña a un gráfico? ¿Qué frase describe un símbolo de una fórmula? A menudo hay que deducir estas relaciones a partir de la posición, el estilo y el contexto. Las columnas, los gráficos, las fórmulas y las tablas complican esa deducción.
Por qué una página PDF no se puede leer como una simple secuencia de texto
Al editar un documento, normalmente sabemos qué es un título, qué es un párrafo y a qué columna pertenece un dato de una tabla. Un PDF se parece más a la apariencia final de la página: texto, líneas, imágenes y espacios en blanco ocupan posiciones concretas, pero no siempre incluyen información estructural clara.
Un mismo párrafo puede estar dividido en numerosos bloques independientes. El texto de un gráfico puede guardarse por separado de sus figuras. Una tabla puede ser solo un conjunto de líneas y números, sin filas y columnas explícitas. En un PDF escaneado, la página es una imagen: primero hay que reconocer en ella los textos, las tablas y las fórmulas.
Por eso, antes de traducir hay que responder algunas preguntas:
- ¿Qué textos pertenecen al mismo párrafo?
- ¿Qué título corresponde al contenido que aparece debajo?
- ¿En qué orden se leen las dos columnas?
- ¿A qué figura o tabla pertenece una explicación?
- ¿Cómo se distinguen las cabeceras y los pies de página del cuerpo del texto?
Sin comprender primero esas relaciones, extraer texto, traducirlo por bloques y colocarlo de nuevo en secuencia puede dar como resultado una página con todas las frases traducidas, pero sin un punto de partida claro para quien lee.
Así, el primer paso no es sustituir palabras, sino intentar comprender la estructura de la página. Técnicamente, se parece más a reconstruir las relaciones entre títulos, párrafos, gráficos y explicaciones sobre una página terminada que a leer una cadena de texto.
En dos columnas, lo difícil es mantener el orden de lectura
Los artículos científicos y los informes técnicos suelen usar dos columnas. No queremos conservar únicamente dos franjas verticales, sino el recorrido de lectura: qué columna va primero, a qué sección pertenece un título y cuándo conviene detenerse a leer una nota al pie.
Una persona puede reconocer enseguida que debe leer primero la columna izquierda y luego la derecha. Para un sistema, sin embargo, la posición del texto no equivale automáticamente a su orden de lectura.
Un párrafo puede dividirse en muchas líneas, cada una reconocida como un bloque distinto. Si solo se siguen las coordenadas o el orden de extracción, el contenido puede saltar a la derecha antes de terminar la izquierda, colocar mal un título, insertar una nota en mitad del cuerpo o atribuir a una sola columna un gráfico que ocupa ambas.
Técnicamente, hay que resolver conjuntamente las regiones de la página, el orden de los bloques y los elementos que interrumpen el flujo normal:
- Identificar los límites entre columnas.
- Distinguir títulos, cuerpo, notas al pie, cabeceras y pies de página.
- Recuperar el orden entre los bloques de texto.
- Ajustar los saltos de línea de la traducción al ancho disponible de la columna.
- Comprobar que se pueda seguir leyendo en el orden original.
Si la traducción es más larga, quizá no quepa en su región de texto original. Forzar la posición de cada línea puede producir superposiciones o huecos excesivos. Una buena reconstrucción no mantiene cada carácter en sus coordenadas antiguas: procura conservar el orden de lectura que proporcionan las columnas.
Un gráfico no es una imagen aislada, sino información relacionada
Los gráficos son una parte fácil de subestimar al traducir PDFs. Lo que debe conservarse no es una imagen «más o menos igual», sino la correspondencia entre elementos gráficos, datos, leyendas, pies de figura y texto principal.
Para quien lee, una figura y el texto cercano forman naturalmente parte de una misma explicación. Dentro del PDF pueden ser objetos independientes, incluso de distintas capas de contenido.
El cuerpo puede estar totalmente traducido, pero si quedan sin tratar los títulos, los ejes, las leyendas y las anotaciones del gráfico, la idea del autor puede seguir sin entenderse. A la inversa, traducir solo las palabras del gráfico sin mantener su vínculo con el cuerpo y el pie de figura también separa información que debería ir unida.
Un gráfico suele incluir varias capas:
- Un título que indica de qué trata.
- Ejes y unidades que permiten interpretar las cifras.
- Una leyenda que explica colores, líneas o símbolos.
- Anotaciones que destacan un resultado o un cambio.
- Un pie de figura y referencias en el cuerpo que añaden condiciones y explicaciones.
Hay que considerar esos elementos como un conjunto. El sistema necesita establecer sus relaciones sin basarse únicamente en la proximidad:
- El pie de figura puede estar debajo o pasar a la página siguiente por un salto de página.
- En una página a dos columnas, el párrafo más cercano no tiene por qué explicar el gráfico.
- Una referencia como «véase la figura 2» puede apuntar a una figura distante.
- Las palabras del gráfico pueden ser texto extraíble o estar integradas en una imagen.
- Hay que traducir ejes, leyendas y etiquetas, sin alterar las cifras ni las relaciones entre datos.
La traducción debe intentar conservar las relaciones entre datos, gráficos y explicaciones, no limitarse a traducir las frases extraíbles. No basta con reconocer «aquí hay texto»; también hay que determinar qué función cumple dentro del gráfico.
Por eso, saber si las palabras están traducidas no basta para evaluar la reconstrucción. También hay que comprobar que la leyenda corresponda, que no falten unidades, que el pie de figura siga localizable y que «figura 2» señale realmente esa figura. Un solo vínculo incorrecto puede cambiar lo que entiende el lector, aunque el gráfico siga presente.
En las fórmulas, el problema está también alrededor
Una fórmula normalmente no necesita traducción. Lo que debemos conservar es su relación con el texto que la rodea: las definiciones de variables, las referencias a su número y las condiciones expresadas antes y después.
Una variable puede explicarse en el párrafo siguiente; el número de una fórmula puede citarse en el cuerpo; una condición cercana puede determinar si la conclusión es válida. Conservar la fórmula pero perder su correspondencia con esas explicaciones, números o contexto dificulta igualmente su uso.
Técnicamente, las fórmulas pueden adoptar distintas formas. Algunas combinan caracteres y líneas vectoriales; otras ya son imágenes y no conservan la estructura matemática del editor original. Al extraerlas, los superíndices, subíndices, radicales y letras griegas pueden separarse o confundirse. Al maquetarlas de nuevo, tampoco se pueden dividir en cualquier punto como una frase corriente. Fórmula, número y referencia deben seguir correspondiéndose: un error de posición u orden no debe hacer que «ecuación (3)» se interprete como otra ecuación.
Como mínimo, conviene comprobar:
- Que los símbolos, superíndices, subíndices y caracteres especiales estén completos.
- Que la numeración coincida con las referencias del cuerpo.
- Que las definiciones de variables permanezcan cerca de su ubicación pertinente.
- Que la fórmula siga siendo legible tras un salto de línea.
- Que las explicaciones de alrededor no se hayan separado incorrectamente.
En artículos científicos y documentación técnica, comprobar que una fórmula «sigue ahí» es solo el requisito más básico. Su relación con el texto anterior y posterior importa tanto como su presencia.
En una tabla, una posición equivocada puede cambiar el significado de una cifra
Lo que hay que conservar en una tabla no son solo sus bordes y líneas, sino las relaciones entre filas, columnas, encabezados, unidades, notas y números. Una cifra adquiere su significado completo junto a la fila, columna, encabezado y unidad correctos.
Los documentos reales pueden contener celdas combinadas, encabezados que continúan entre páginas, columnas sin bordes o tablas hechas con espacios. Si una traducción alarga el texto de una celda, puede afectar al ancho de toda la columna. Devolverlo sin más a sus coordenadas originales puede provocar desbordamientos, tapar la columna siguiente o hacer que una cifra parezca pertenecer a otra fila.
Por tanto, deben preservarse las relaciones entre filas y columnas, la jerarquía de encabezados, las unidades y las notas, no solo volver a dibujar las líneas donde estaban.
Cuando la traducción crece, la página necesita otro equilibrio
Incluso después de identificar correctamente la estructura, queda un problema práctico: cada idioma necesita un espacio distinto para expresar la misma idea. No se trata de mantener las coordenadas de cada carácter, sino unas relaciones espaciales claras entre títulos, párrafos, gráficos y fórmulas.
Un párrafo inglés traducido al chino puede acortarse o alargarse por los términos, paréntesis y explicaciones. Al cambiar de idioma, también cambian las posibilidades de dividir palabras, la disposición de la puntuación y la anchura de las fuentes. Todo ello afecta al resultado.
Esto puede modificar:
- Los saltos de línea en las dos columnas.
- La necesidad de que un título ocupe dos líneas.
- El espacio que queda junto a un gráfico.
- Si el texto de una tabla rebasa su celda.
- Si las regiones originales admiten la traducción completa.
La nueva maquetación no puede limitarse a pegar el texto traducido en las cajas antiguas. Debe equilibrar la similitud estructural y la comodidad de lectura.
Cómo abordamos la conservación de estas relaciones
En iSomor, reconstruir la maquetación forma parte de la traducción; no es un adorno añadido al final. El procesamiento actual parte de PDFs con texto extraíble y conecta reconocimiento del diseño, organización de párrafos, traducción y composición de la versión traducida. Los siguientes pasos explican qué abordamos y cómo valoramos la utilidad del resultado. No significan que todas las relaciones complejas ya se reconozcan y verifiquen automáticamente.
Empezar por unidades de contenido comprensibles
El análisis combina posiciones del texto y regiones de la página para distinguir, en lo posible, cuerpo, títulos, gráficos, fórmulas y otros elementos, y formar los párrafos que se traducirán. El objetivo no es fragmentar más, sino evitar separar textos relacionados o mezclar regiones distintas.
Las tablas son un ejemplo concreto. Nuestra implementación utiliza información de las regiones de las celdas para ayudar a agrupar después los párrafos: intenta tratar juntas las líneas de una misma celda y no mezclar contenido de celdas diferentes. Esto no significa que todas las tablas se reconstruyan correctamente. Las tablas sin bordes, los encabezados complejos y las celdas con varios párrafos todavía pueden generar errores de agrupación y requieren comprobación.
Mantener junta la información relacionada, cuando sea posible
Reconocer una figura no basta. La utilidad del resultado también depende de que sus pies, leyendas y referencias sigan correspondiéndose. Lo mismo ocurre con las fórmulas y sus números y definiciones de variables.
Esto es, ante todo, un objetivo de reconstrucción, no una promesa de que el sistema comprenda todas las referencias. Conservar los gráficos originales, los números y la posición del texto cercano ayuda a comprobarlos. Pero una página aparentemente completa no demuestra que se hayan tratado correctamente los pies de figura entre páginas, las referencias lejanas o el texto integrado en imágenes.
Conservar el contexto necesario dentro de los párrafos
Actualmente se traduce por párrafos, en vez de tratar cada línea como una frase independiente. Organizar bien los párrafos reduce la pérdida de contexto provocada por cortar una frase.
Sin embargo, agrupar párrafos no garantiza por sí solo una terminología uniforme en todo el documento. Un mismo término puede traducirse de manera distinta en títulos, cuerpo, leyendas o tablas, especialmente si están en regiones separadas. Recomendamos comprobar términos y conclusiones importantes con el original, sin confundir una traducción terminada con una revisión de coherencia de todo el documento.
Recalcular el espacio para la traducción
Al cambiar la longitud del texto, hay que ajustar saltos y distribución al espacio disponible, conservando gráficos, fórmulas y otros elementos en lo posible. Que un párrafo quepa no garantiza que no choque con las regiones vecinas.
Un título de dos líneas puede invadir el contenido inferior; un pie de figura más largo puede exceder su espacio; una celda traducida puede alcanzar la columna contigua. Recomponer la página significa buscar una distribución legible entre regiones que se condicionan mutuamente, no pegar cada carácter en su posición anterior. No presentamos el reajuste automático del ancho de columnas, el traslado de gráficos entre páginas o la repaginación como resultados garantizados para cualquier archivo.
El resultado no tiene por qué coincidir píxel a píxel con el original. Es más importante que se distingan títulos y cuerpo, se encuentre la explicación de cada gráfico y se pueda seguir el argumento original.
Volver al original para revisar contenido y maquetación
Una página ordenada no es necesariamente correcta. La revisión debe separar tres problemas: contenido ausente o repetido, relaciones mal asignadas y superposiciones, cortes u órdenes incorrectos. Son criterios para revisar el resultado, no una afirmación de que la herramienta haya completado automáticamente toda la verificación visual y de contenido.
Un gráfico puede aparecer entero, pero sin una relación clara con su pie; una fórmula puede estar presente con subíndices o superíndices mal colocados; una tabla puede parecer alineada con una cifra en la columna vecina. Detectar estos problemas requiere comparar contenido y estructura, no solo mirar una captura final.
Para cifras, términos, fórmulas y conclusiones, el original sigue siendo una referencia importante. Conservar la maquetación facilita la búsqueda y la comprobación, pero no sustituye el criterio del lector sobre la información esencial.
Buscamos un documento que se pueda seguir leyendo, no una imagen idéntica
«Conservar» puede sugerir que cada carácter y cada línea deben quedar exactamente en el mismo lugar. Cuando cambia el idioma, ese objetivo no siempre es razonable.
Reducir demasiado la letra para mantener el número de líneas o apretar los párrafos puede acercar la apariencia al original y dificultar la lectura. En cambio, ajustar moderadamente saltos, tamaño de letra o interlineado dentro del espacio disponible puede facilitarla, siempre que sigan claras las relaciones entre títulos, gráficos, fórmulas y explicaciones.
Por eso nos importan más algunas preguntas prácticas:
- ¿Se ha conservado todo el contenido?
- ¿Está claro el orden de lectura?
- ¿Se corresponden gráficos, fórmulas y cuerpo del texto?
- ¿Puede el lector volver al original cuando necesita comprobar algo?
- ¿La página sigue siendo útil para leer de verdad?
Ese es el problema que iSomor quiere abordar. No buscamos convertir un PDF en una sucesión de frases traducidas, sino mantenerlo como un documento que se pueda leer, consultar y seguir utilizando.
Los archivos complejos siguen necesitando revisión
Los PDFs varían mucho según su origen y elaboración. iSomor trabaja actualmente con PDFs que contienen texto extraíble; el OCR necesario para páginas completamente escaneadas no está disponible en el alcance actual. Incluso en PDFs de texto, las tablas anidadas complejas, las fuentes especiales y el texto integrado en imágenes pueden superar los límites del procesamiento automático.
Por eso, después de traducir conviene volver al original, especialmente para comprobar cifras, fórmulas, gráficos y conclusiones importantes de un artículo científico. No consideramos una página ordenada una prueba de que todo su contenido sea correcto.
Para nosotros, el sentido del trabajo técnico no es trasladar la complejidad al lector, sino resolver de antemano, en lo posible, lo que interrumpe su lectura. Cada reorganización o búsqueda de una correspondencia que se ahorra le deja más espacio para concentrarse en el documento mismo.