
為什麼 PDF 翻譯這麼難?我們到底在還原什麼?
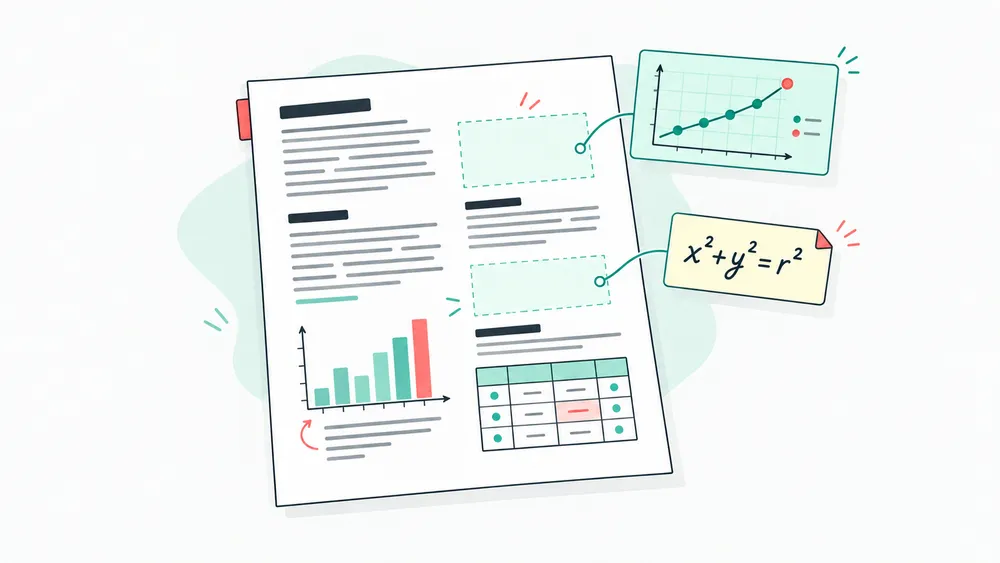
上一篇文章《從閱讀習慣看,為什麼翻譯 PDF 時需要保留原來的排版?》中,我們從閱讀習慣出發,談到為什麼翻譯 PDF 時,不能只留下翻譯後的文字。閱讀論文、報告或技術資料時,我們會看標題、找圖表,也會在原文與譯文之間來回核對。原來的排版,幫助我們記住這些內容之間的關係。
但從技術上看,保留這些關係並不簡單。
PDF 翻譯不是把一種語言換成另一種語言,再把文字放回原來的位置。它還需要理解一頁內容由什麼組成、判斷哪些文字屬於同一部分,並在譯文長度改變之後,重新安排頁面。
真正困難的地方在於:PDF 通常只告訴我們一個元素「放在哪裡」,卻不一定告訴我們它「屬於什麼」。一段文字屬於哪個標題、圖表對應哪段說明、公式中的符號與哪句話有關,這些關係往往需要從位置、樣式與上下文推斷。雙欄、圖表、公式和表格,都會讓這種推斷更複雜。
一頁 PDF,為什麼不能直接當作文字讀取
編輯文件時,我們通常知道標題是標題、段落是段落,也知道表格中的資料屬於哪一欄。但 PDF 更接近「頁面最後呈現的樣子」:文字、線條、圖片與留白各自放在指定位置,卻不一定帶有清楚的結構資訊。
同一段話可能被拆成許多獨立的文字區塊,圖表中的文字可能與圖形分開儲存,表格也可能只有一組線條和數字,沒有明確的列、欄資訊。掃描 PDF 更特別:頁面上看到的是一張圖片,文字、表格與公式都需要先從影像辨識出來。
因此,翻譯前需要先回答一些問題:
- 哪些文字屬於同一個段落?
- 哪個標題對應下方的內容?
- 兩欄文字的閱讀順序是什麼?
- 一段說明屬於哪張圖或哪張表?
- 頁首、頁尾與正文應該如何區分?
如果沒有先理解這些關係,就直接擷取文字、逐段翻譯,再依序放回頁面,結果可能是每句話都翻好了,讀者卻不知道該從哪裡讀起。
所以,PDF 翻譯的第一步不是替換文字,而是盡量理解頁面的結構。技術上,這更像是在一張已經完成的頁面上,重新建立「標題—段落—圖表—說明」的關係,而不是單純讀取一串文字。
雙欄排版,真正困難的是先後順序
論文與技術報告經常採用雙欄排版。我們要還原的不是兩條直立的區域,而是讀者沿著頁面閱讀的路徑:先讀哪一欄、標題屬於哪一部分、讀到哪裡時該停下來看註腳。
人眼可以很快判斷應該先讀左欄,再讀右欄;但對處理系統來說,文字在頁面上的位置,並不自然等同於閱讀順序。
一段文字可能被拆成很多行,每一行又被辨識成獨立的文字區塊。如果只按照座標或擷取順序處理,就可能出現幾種情況:左欄還沒讀完,內容已經跳到右欄;標題被放錯位置;註腳插進正文中間;跨欄圖表被誤認為只屬於其中一欄。
技術上,系統需要同時處理頁面分區、文字區塊排序,以及穿插其中的特殊內容:
- 先判斷欄與欄之間的邊界;
- 辨識標題、正文、註腳與頁首頁尾;
- 還原各個文字區塊的先後關係;
- 翻譯後,在可用欄寬內重新安排換行;
- 檢查讀者是否仍能按照原來的順序讀下去。
如果譯文比原文長,原來的文字區域可能容納不下。強行維持每一行的位置,容易造成文字重疊或留白過大。好的還原,不是讓每個字都停在原來的座標上,而是盡量保留雙欄帶來的閱讀秩序。
圖表不是一張圖,而是一組彼此關聯的資訊
圖表是 PDF 翻譯中很容易被低估的部分。我們要還原的不是一張「看起來差不多」的圖,而是圖形、資料、圖例、圖說與正文之間的對應關係。
對讀者而言,一張圖和附近的文字自然屬於同一段論述;但在 PDF 內部,它們可能是彼此獨立的物件,甚至來自不同的內容圖層。
正文可以完整翻譯,但如果圖表中的標題、座標軸、圖例與註解沒有處理,讀者仍可能無法理解作者想說明什麼。反過來,如果只翻譯圖表裡的文字,卻沒有保留它與正文、圖說的對應關係,資訊也會被拆散。
一張圖通常包含幾層內容:
- 圖表標題,說明正在討論什麼;
- 座標軸與單位,說明數字應該如何理解;
- 圖例,說明不同顏色、線條或標記的意義;
- 圖中的標註,指出某個結果或變化;
- 圖說與正文引用,補充適用條件和解釋。
這些內容需要視為一個整體。技術上,系統要判斷它們之間的關聯,不能只依靠「距離很近」這條規則:
- 圖說可能在圖的下方,也可能因分頁出現在下一頁;
- 雙欄頁面中,最近的一段文字不一定是圖表說明;
- 正文可能透過「見圖 2」這類引用,指向距離較遠的圖表;
- 圖表裡的文字可能是可擷取文字,也可能已經與圖形合併成圖片;
- 座標軸、圖例與資料標籤需要翻譯,但數字和資料關係不能改動。
翻譯時要盡量保留資料、圖形與說明之間的關係,而不只是翻譯能擷取出來的句子。換句話說,系統不只要辨識「這裡有一段文字」,還要判斷「這段文字在這張圖裡扮演什麼角色」。
這也是為什麼圖表還原不能只用「文字是否翻譯」來判斷。還要檢查:圖例是否對應正確、單位是否遺漏、圖說是否仍然找得到,以及正文提到的「圖 2」是否真的指向那張圖。只要其中一個關聯出錯,即使圖表還在,讀者理解到的內容也可能已經改變。
公式難處理的,是它周圍的關係
公式本身通常不需要翻譯,但我們要還原的是它與周圍文字的關係:變數如何解釋、編號如何引用、公式前後的限制條件如何保留。
例如,公式中的變數可能在下一段才解釋,公式編號可能被正文引用,前後的限制條件也可能決定結論是否成立。如果只保留公式,卻讓變數說明、編號或上下文失去對應,讀者仍然很難運用它。
從技術上看,公式也可能以不同形式存在:有些由文字字元和向量線條組成,有些已經是圖片,不一定保留原編輯器中的數學結構。擷取時,上標、下標、根號與希臘字母可能被拆散或混淆;重新排版時,公式又不能像一般句子那樣任意換行。公式、編號與正文引用也需要維持對應,不能因為位置或順序處理錯誤,讓讀者把「公式(3)」理解成另一個公式。
因此,公式還原至少要關注幾件事:
- 公式中的符號、上下標與特殊字元是否完整;
- 公式編號是否與正文引用一致;
- 變數說明是否仍在相關位置附近;
- 公式換行後是否清楚易讀;
- 公式周圍的解釋文字是否被錯誤拆開。
對論文與技術資料來說,公式是否「看起來還在」只是最基本的檢查。它與前後文字的關係同樣重要。
表格錯一個位置,數字就可能變成另一個意思
表格要還原的不是框線本身,而是列、欄、表頭、單位、註解與數字之間的關係。表格中的數字,只有與正確的列、欄、表頭和單位放在一起,才具有完整意義。
實際文件可能包含合併儲存格、跨頁表頭、沒有框線的隱藏欄位,甚至只是用空白排出來的文字。翻譯後,某個儲存格的文字變長,可能影響整欄寬度;如果只按照原座標放回去,文字可能溢出、遮住下一欄,或讓讀者誤以為某個數字屬於另一列。
因此,表格還原要保留的是列欄關係、表頭層級、單位與註解,而不只是把線條畫回相同位置。
譯文變長後,頁面需要重新取得平衡
即使已正確辨識頁面結構,翻譯完成後仍有一個實際問題:不同語言表達同一個意思,所需空間並不相同。這裡要還原的不是每個字元的原座標,而是標題、段落、圖表與公式之間依然清楚的空間關係。
英文段落譯成中文後,可能變短,也可能因術語、括號與解釋變長。換一種語言,單字能否換行、標點如何排列、字型寬度如何改變,都會影響頁面最後的樣子。
這會進一步影響:
- 雙欄中的換行位置;
- 標題是否需要占用兩行;
- 圖表旁是否還有足夠空間;
- 表格文字是否超出儲存格;
- 原來的頁面區域是否能容納完整譯文。
因此,翻譯後的排版不能只是把譯文貼回原來的文字框,而需要在結構相近與閱讀舒適之間取得平衡。
我們如何把這些關係還原回來
在 iSomor 的處理思路中,排版還原不是最後才補上的裝飾,而是翻譯過程的一部分。目前以可擷取文字的 PDF 為處理基礎,串接頁面配置辨識、段落組織、翻譯與譯文排版。以下幾個環節既說明我們在處理什麼,也說明如何判斷還原是否有用;不表示所有複雜關係都已能自動辨識與驗證。
先把頁面拆成可以理解的內容物件
頁面解析需要結合文字位置與版面區域,盡量區分正文、標題、圖表和公式等內容,再組織需要翻譯的段落。目標不是把頁面切成更多小塊,而是減少本應相連的文字被拆開、不同區域的文字混在一起的情況。
表格就是具體例子。我們的實作加入了儲存格區域資訊,輔助後續段落分組:同一格裡的幾行文字,盡量放在一起理解;不同格的內容,盡量不要混在一起。但這不代表所有表格都已準確重建。無框線表格、複雜表頭與格內多段內容,仍可能發生分組錯誤,需要進一步核查。
讓相關資訊盡量留在一起
辨識出圖表還不夠。還原結果是否有用,也要看圖說、圖例與正文引用能否對應;公式也是一樣,編號與變數說明不能失去聯繫。
這首先是一項還原目標,而不是承諾系統已理解所有引用關係。在實際檔案中,保留原有圖形、編號及附近文字的位置關係,有助於讀者繼續核對;但面對跨頁圖說、遠距離引用,或已合併到圖片裡的文字,不能只因頁面看起來完整,就認定關聯已被正確處理。
在段落中保留必要的上下文
目前翻譯以段落為單位,而不是將每一行文字視為獨立句子。盡量正確組織段落,可以減少句子被截斷後失去上下文的問題。
但段落分組不能自動保證全文術語一致。同一個術語在標題、正文、圖例與表格中仍可能有不同譯法,尤其當它們分屬不同區域時。對重要術語與結論,我們仍建議對照原文核查,不把翻譯完成視為已完成全文一致性檢查。
根據譯文重新計算頁面空間
文字長度改變後,需要依可用區域重新安排換行與文字配置,同時盡量保留圖表、公式等內容。困難在於,單一段落放得下,不代表它就不會與相鄰區域衝突。
例如,標題譯成兩行後是否擠到下方內容;圖說變長後是否超出原有空間;表格中的譯文是否碰到相鄰欄位。這些都說明,重新排版是在彼此牽制的區域中尋找可讀的配置,而不是逐字貼回原座標。我們不把自動重建欄寬、跨頁移動圖表或重新分頁,視為所有檔案都能得到的效果。
最終結果不一定與原檔逐像素相同。更重要的是,讀者仍能區分標題與正文、找到圖表對應的說明,並沿著原來的論述繼續讀下去。
最後回到原文,檢查內容與版面
頁面看起來整齊,不代表內容已經正確。核查時需要分別看三類問題:內容有無遺漏或重複、關係有無錯配,以及頁面有無重疊、截斷或順序錯誤。這些是檢查結果時應留意的面向,不表示工具已自動完成所有內容與視覺驗證。
例如,圖表可能完整出現在頁面上,但它與圖說的對應關係已變得不清楚;公式可能沒有遺漏,上下標卻放錯位置;表格看起來對齊,某個數字卻落到相鄰欄位。這些問題需要透過內容與結構的對照來發現,不能只靠最後的截圖檢查。
對數字、術語、公式與結論而言,原文仍是重要參照。排版還原可以減少尋找與核對的阻力,卻不能取代讀者對關鍵內容的判斷。
我們追求的是能繼續閱讀,而不是一張完全相同的圖片
「還原」很容易被理解為每個字、每條線都必須停在與原文完全相同的位置。但語言已經改變時,這個目標不一定合理。
如果為了維持原來的行數,把譯文縮得很小,或讓段落擠在一起,頁面雖然更像原文,閱讀反而更困難。相反地,在可用區域內適度調整換行、字級或行距,只要標題、圖表、公式與說明之間的關係依然清楚,讀者可能更容易讀下去。
因此,我們更關心幾件實際的事:
- 內容是否完整保留;
- 閱讀順序是否清楚;
- 圖表、公式與正文能否對應;
- 讀者需要時能否回到原文核對;
- 頁面是否仍適合實際閱讀。
這也是 iSomor 希望解決的問題。我們不是把 PDF 變成一串翻譯後的句子,而是盡量讓它仍像一份可以閱讀、查找與持續使用的資料。
複雜檔案仍需要檢查
不同 PDF 的來源與製作方式差異很大。iSomor 目前處理包含可擷取文字的 PDF;整頁掃描影像所需的 OCR 辨識不在目前開放範圍內。即使是文字 PDF,複雜的巢狀表格、特殊字型,以及合併到圖片中的文字,也可能超出自動處理的能力範圍。
因此,翻譯完成後,尤其是論文中的關鍵數字、公式、圖表與結論,仍值得回到原文檢查。我們不把版面看起來整齊,當作內容已完全正確的證明。
對我們來說,技術工作的意義不是把複雜性轉交給讀者,而是盡量預先處理那些會打斷閱讀的部分。少一次重新整理、少一次尋找對應位置,讀者就多一點機會把注意力放回資料本身。