
Warum ist PDF-Übersetzung so schwierig? Was stellen wir eigentlich wieder her?
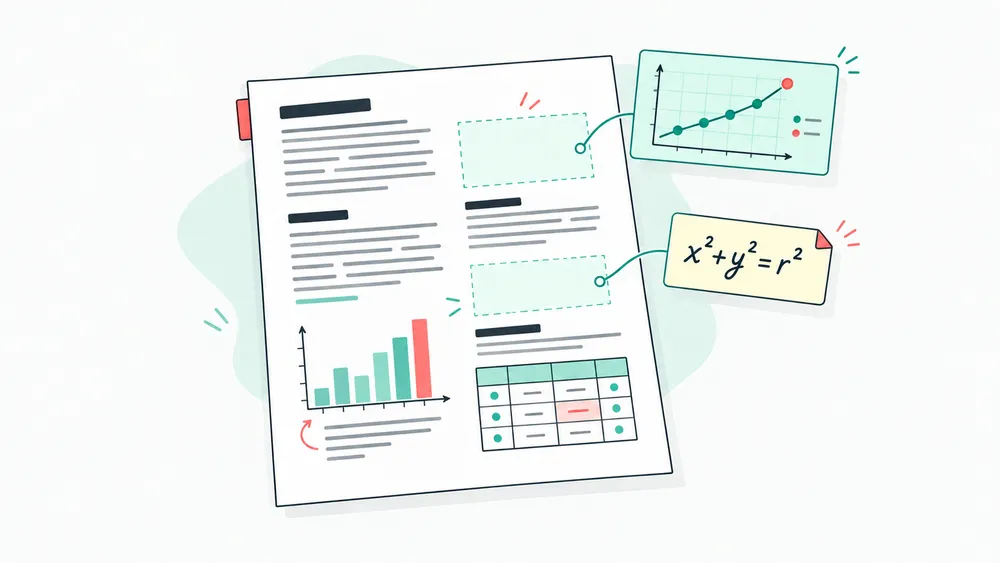
Im vorherigen Artikel „Warum das Layout beim Übersetzen von PDFs wichtig ist – ein Blick auf unsere Lesegewohnheiten“ haben wir anhand unserer Lesegewohnheiten erklärt, warum nach einer PDF-Übersetzung mehr als übersetzter Text übrig bleiben sollte. Beim Lesen einer wissenschaftlichen Arbeit, eines Berichts oder technischer Unterlagen suchen wir Überschriften und Abbildungen und wechseln zum Prüfen zwischen Original und Übersetzung. Das ursprüngliche Layout hilft uns, die Zusammenhänge im Gedächtnis zu behalten.
Technisch ist es allerdings nicht einfach, diese Zusammenhänge zu bewahren.
Eine PDF zu übersetzen bedeutet nicht nur, eine Sprache durch eine andere zu ersetzen und die Wörter wieder an ihre alten Positionen zu setzen. Dazu gehört auch, den Aufbau einer Seite zu verstehen, zusammengehörige Texte zu erkennen und Inhalte neu anzuordnen, wenn sich ihre Länge durch die Übersetzung verändert.
Die eigentliche Schwierigkeit: Eine PDF verrät häufig, wo ein Element steht, aber nicht unbedingt, wozu es gehört. Welcher Überschrift ist ein Absatz zugeordnet? Welche Erläuterung gehört zu welcher Grafik? Welcher Satz erklärt ein Formelzeichen? Solche Beziehungen müssen oft aus Position, Gestaltung und Kontext erschlossen werden. Spalten, Diagramme, Formeln und Tabellen machen das noch komplexer.
Warum eine PDF-Seite nicht einfach als Textstrom gelesen werden kann
Beim Bearbeiten eines Dokuments wissen wir normalerweise, was eine Überschrift oder ein Absatz ist und zu welcher Spalte ein Tabelleneintrag gehört. Eine PDF bildet dagegen eher das fertige Erscheinungsbild einer Seite ab: Text, Linien, Bilder und Freiräume stehen an bestimmten Stellen, ohne unbedingt eindeutige Strukturinformationen mitzubringen.
Ein Absatz kann in viele unabhängige Textblöcke zerlegt sein. Beschriftungen können getrennt von den grafischen Elementen eines Diagramms gespeichert sein. Eine Tabelle besteht möglicherweise nur aus Linien und Zahlen, ohne ausdrücklich definierte Zeilen und Spalten. Bei gescannten PDFs ist die Seite selbst ein Bild; Text, Tabellen und Formeln müssen zunächst darin erkannt werden.
Vor der Übersetzung sind deshalb einige Fragen zu klären:
- Welche Texte bilden gemeinsam einen Absatz?
- Welche Überschrift gehört zum nachfolgenden Inhalt?
- In welcher Reihenfolge werden zwei Spalten gelesen?
- Zu welcher Abbildung oder Tabelle gehört eine Erläuterung?
- Wie lassen sich Kopf- und Fußzeilen vom Haupttext unterscheiden?
Wer diese Beziehungen nicht zuerst versteht, sondern Text nur extrahiert, abschnittsweise übersetzt und der Reihe nach zurücksetzt, kann eine Seite erhalten, auf der zwar jeder Satz übersetzt ist, die Lesenden aber nicht wissen, wo sie anfangen sollen.
Der erste Schritt ist daher nicht das Ersetzen von Wörtern, sondern das möglichst genaue Verständnis der Seitenstruktur. Technisch ähnelt das eher dem Wiederherstellen der Beziehungen zwischen Überschriften, Absätzen, Abbildungen und Erläuterungen auf einer fertigen Seite als dem Lesen einer Zeichenfolge.
Bei zwei Spalten ist die Reihenfolge entscheidend
Wissenschaftliche Arbeiten und technische Berichte sind oft zweispaltig gesetzt. Bewahren wollen wir nicht einfach zwei senkrechte Flächen, sondern den Weg durch die Seite: Welche Spalte kommt zuerst, wohin gehört eine Überschrift, und wann sollte man eine Fußnote lesen?
Menschen erkennen oft schnell, dass zuerst die linke, dann die rechte Spalte zu lesen ist. Für ein Verarbeitungssystem ergibt sich diese Reihenfolge aber nicht automatisch aus den Textpositionen.
Ein Absatz kann aus vielen Zeilen bestehen, die jeweils als eigener Textblock erkannt werden. Eine Verarbeitung nur nach Koordinaten oder Extraktionsreihenfolge kann mitten in der linken Spalte nach rechts springen, Überschriften falsch platzieren, Fußnoten in den Haupttext schieben oder eine spaltenübergreifende Abbildung nur einer Spalte zuordnen.
Technisch müssen Seiteneinteilung, Reihenfolge der Textblöcke und eingeschobene Sonderinhalte zusammen behandelt werden:
- Die Grenzen zwischen den Spalten bestimmen.
- Überschriften, Haupttext, Fußnoten sowie Kopf- und Fußzeilen erkennen.
- Die Reihenfolge der Textblöcke wiederherstellen.
- Nach der Übersetzung Zeilenumbrüche innerhalb der verfügbaren Spaltenbreite neu berechnen.
- Prüfen, ob der ursprüngliche Lesefluss erhalten bleibt.
Wird die Übersetzung länger, passt sie möglicherweise nicht mehr in den alten Textbereich. Jede Zeile an ihrer bisherigen Position festzuhalten kann zu Überlagerungen oder zu großen Lücken führen. Gute Rekonstruktion hält nicht jedes Zeichen an seinen ursprünglichen Koordinaten fest, sondern möglichst die Leseordnung des zweispaltigen Satzes.
Ein Diagramm ist mehr als ein Bild
Diagramme werden bei der PDF-Übersetzung leicht unterschätzt. Zu bewahren ist nicht eine ungefähr gleich aussehende Grafik, sondern der Zusammenhang zwischen Darstellung, Daten, Legende, Bildunterschrift und Haupttext.
Für Lesende gehören eine Abbildung und der benachbarte Text selbstverständlich zu derselben Argumentation. In der PDF können sie jedoch unabhängige Objekte sein, mitunter sogar auf verschiedenen Inhaltsebenen.
Der Haupttext kann vollständig übersetzt sein, während Diagrammtitel, Achsen, Legenden und Anmerkungen unbearbeitet bleiben. Dann ist die Aussage möglicherweise weiterhin unverständlich. Umgekehrt reißt auch die isolierte Übersetzung der Diagrammbeschriftung Informationen auseinander, wenn ihre Beziehung zum Haupttext und zur Bildunterschrift verloren geht.
Eine Abbildung umfasst häufig mehrere Informationsebenen:
- Den Titel, der das Thema benennt.
- Achsen und Einheiten, die die Zahlen verständlich machen.
- Eine Legende, die Farben, Linien und Symbole erklärt.
- Anmerkungen, die Ergebnisse oder Veränderungen hervorheben.
- Bildunterschrift und Verweise im Haupttext, die Bedingungen und Erklärungen ergänzen.
Diese Elemente müssen gemeinsam betrachtet werden. Ihre Zuordnung lässt sich technisch nicht allein mit räumlicher Nähe bestimmen:
- Eine Bildunterschrift kann unter der Grafik stehen oder durch einen Seitenumbruch auf der Folgeseite landen.
- Im zweispaltigen Satz ist der nächstgelegene Absatz nicht zwingend die Erklärung zur Grafik.
- Ein Verweis wie „siehe Abbildung 2“ kann auf eine weit entfernte Darstellung zeigen.
- Beschriftungen können extrahierbarer Text oder bereits Bestandteil eines Bildes sein.
- Achsen, Legenden und Datenbeschriftungen brauchen Übersetzung, Zahlen und Datenbeziehungen dürfen sich dabei nicht verändern.
Die Übersetzung sollte Daten, Darstellung und Erklärung möglichst zusammenhalten, statt nur extrahierbare Sätze zu übersetzen. Das System muss also nicht nur erkennen, dass irgendwo Text steht, sondern auch, welche Rolle dieser Text in der Grafik spielt.
Deshalb reicht die Frage „Ist der Text übersetzt?“ nicht aus. Ebenso wichtig ist, ob die Legende noch richtig zugeordnet ist, Einheiten fehlen, die Bildunterschrift auffindbar bleibt und „Abbildung 2“ tatsächlich auf diese Abbildung verweist. Schon eine fehlerhafte Beziehung kann die verstandene Aussage verändern, obwohl die Grafik noch vorhanden ist.
Bei Formeln sind die Beziehungen zum Umfeld schwierig
Eine Formel selbst muss normalerweise nicht übersetzt werden. Bewahrt werden müssen ihre Verbindungen zum Text: die Erklärung der Variablen, Verweise auf Formelnummern und die Bedingungen vor und nach der Formel.
Eine Variable wird vielleicht erst im nächsten Absatz erklärt, die Formelnummer im Haupttext aufgegriffen und eine Voraussetzung daneben bestimmt, ob eine Schlussfolgerung gilt. Bleibt nur die Formel erhalten, nicht aber ihre Zuordnung zu Erläuterungen, Nummer und Kontext, lässt sie sich weiterhin schwer nutzen.
Auch technisch liegen Formeln in unterschiedlichen Formen vor. Manche bestehen aus Textzeichen und Vektorlinien, andere sind Bilder und enthalten nicht mehr die mathematische Struktur des ursprünglichen Editors. Beim Extrahieren können hoch- und tiefgestellte Zeichen, Wurzelzeichen und griechische Buchstaben getrennt oder verwechselt werden. Beim Neusatz darf eine Formel zudem nicht beliebig wie ein normaler Satz umbrochen werden. Formel, Nummer und Verweis müssen zueinander passen; ein Positions- oder Reihenfolgefehler darf „Formel (3)“ nicht auf eine andere Formel beziehen.
Mindestens folgende Punkte sind zu prüfen:
- Sind Symbole, hoch- und tiefgestellte Zeichen und Sonderzeichen vollständig?
- Stimmen Formelnummern mit den Verweisen im Text überein?
- Stehen Variablenerklärungen weiterhin an der passenden Stelle in der Nähe?
- Bleibt die Formel nach einem Umbruch gut lesbar?
- Wurden die umgebenden Erklärungen versehentlich auseinandergerissen?
Bei wissenschaftlichen und technischen Texten ist „Die Formel ist noch zu sehen“ nur die grundlegendste Kontrolle. Ihre Verbindung zum Text davor und danach ist ebenso wichtig.
Eine verrutschte Tabellenzelle kann die Bedeutung einer Zahl ändern
Bei Tabellen geht es nicht primär um Rahmen und Linien, sondern um Beziehungen zwischen Zeilen, Spalten, Überschriften, Einheiten, Anmerkungen und Zahlen. Erst mit der richtigen Zeile, Spalte, Überschrift und Einheit hat eine Zahl ihre vollständige Bedeutung.
Reale Dateien können verbundene Zellen, seitenübergreifende Tabellenköpfe, Spalten ohne Rahmen oder lediglich mit Leerzeichen ausgerichtete Texte enthalten. Längerer übersetzter Text in einer Zelle kann die ganze Spaltenbreite beeinflussen. Wird er nur an die alten Koordinaten gesetzt, kann er überlaufen, die nächste Spalte verdecken oder eine Zahl einer anderen Zeile zugehörig erscheinen lassen.
Zu erhalten sind daher Zeilen- und Spaltenbeziehungen, die Hierarchie der Tabellenköpfe, Einheiten und Anmerkungen – nicht bloß Linien an denselben Stellen.
Wenn die Übersetzung wächst, braucht die Seite ein neues Gleichgewicht
Auch nach korrekter Strukturerkennung bleibt ein praktisches Problem: Verschiedene Sprachen benötigen unterschiedlich viel Platz für dieselbe Aussage. Bewahrt werden sollen hier nicht die Koordinaten jedes Zeichens, sondern klare räumliche Beziehungen zwischen Überschriften, Absätzen, Diagrammen und Formeln.
Ein englischer Absatz kann auf Chinesisch kürzer werden, durch Fachbegriffe, Klammern und Erklärungen aber auch länger. Mit der Sprache ändern sich mögliche Wortumbrüche, die Anordnung von Satzzeichen und die Zeichenbreite der Schrift. All das beeinflusst das Seitenbild.
Das wirkt sich unter anderem darauf aus,
- wo im zweispaltigen Text Zeilen umbrechen;
- ob eine Überschrift zwei Zeilen benötigt;
- wie viel Platz neben einer Grafik bleibt;
- ob Tabellentext aus einer Zelle herausragt;
- ob die bisherigen Seitenbereiche die vollständige Übersetzung aufnehmen können.
Übersetzter Text lässt sich deshalb nicht einfach in die alten Textfelder einkleben. Es braucht ein Gleichgewicht zwischen ähnlicher Struktur und angenehmer Lesbarkeit.
Wie wir diese Beziehungen erhalten wollen
Bei iSomor gehört die Layoutrekonstruktion zum Übersetzungsprozess und ist keine nachträgliche Dekoration. Aktuell verarbeiten wir PDFs mit extrahierbarem Text und verbinden Layout-Erkennung, Absatzbildung, Übersetzung und Satz des übersetzten Textes. Die folgenden Schritte erklären, was wir bearbeiten und woran wir einen brauchbaren Aufbau erkennen. Sie bedeuten nicht, dass bereits jede komplexe Beziehung automatisch erkannt und überprüft wird.
Zuerst sinnvolle Inhaltseinheiten erkennen
Die Seitenanalyse verbindet Textpositionen mit Layoutbereichen, um Haupttext, Überschriften, Grafiken, Formeln und andere Inhalte möglichst zu unterscheiden und übersetzbare Absätze zu bilden. Ziel sind nicht immer kleinere Teile, sondern weniger zerrissene Textzusammenhänge und weniger Vermischung verschiedener Bereiche.
Ein konkretes Beispiel sind Tabellen. Unsere Implementierung nutzt Informationen über Zellbereiche als Hilfe für die anschließende Absatzgruppierung: Zeilen derselben Zelle sollen möglichst zusammen verarbeitet und Inhalte verschiedener Zellen nicht vermischt werden. Das heißt nicht, dass jede Tabelle korrekt rekonstruiert ist. Rahmenlose Tabellen, komplexe Köpfe und mehrere Absätze in einer Zelle können weiterhin Gruppierungsfehler verursachen und müssen geprüft werden.
Zusammengehörige Informationen möglichst zusammenhalten
Eine Grafik zu erkennen genügt nicht. Brauchbar ist das Ergebnis erst, wenn auch Bildunterschrift, Legende und Textverweise zugeordnet bleiben. Bei Formeln gilt das ebenso für Nummern und Variablenerklärungen.
Das ist zunächst ein Rekonstruktionsziel, keine Zusage, dass das System jede Verweisbeziehung versteht. Originalgrafiken, Nummern und die räumliche Nähe von Text zu erhalten hilft beim Abgleichen. Bei seitenübergreifenden Bildunterschriften, weit entfernten Verweisen oder Text in Bildern beweist ein vollständig wirkendes Seitenbild aber noch keine korrekte Verarbeitung dieser Beziehungen.
Den nötigen Kontext im Absatz bewahren
Die aktuelle Übersetzung arbeitet absatzweise, statt jede Textzeile als eigenständigen Satz zu behandeln. Möglichst richtig gebildete Absätze verringern den Kontextverlust durch getrennte Sätze.
Absatzgruppierung garantiert jedoch nicht automatisch einheitliche Fachbegriffe im gesamten Dokument. Ein Begriff kann in Überschriften, Haupttext, Legenden und Tabellen weiterhin unterschiedlich übersetzt werden, besonders wenn diese in getrennten Bereichen liegen. Wichtige Begriffe und Schlussfolgerungen sollten deshalb mit dem Original verglichen werden. Eine fertige Übersetzung ist nicht gleichbedeutend mit einer abgeschlossenen Konsistenzprüfung des gesamten Textes.
Den Platz für die Übersetzung neu berechnen
Ändert sich die Textlänge, müssen Umbrüche und Textanordnung im verfügbaren Raum angepasst werden, während Grafiken und Formeln möglichst erhalten bleiben. Dass ein einzelner Absatz hineinpasst, schließt Konflikte mit benachbarten Bereichen nicht aus.
Drängt eine zweizeilige Überschrift den folgenden Text zusammen? Ragt eine längere Bildunterschrift aus ihrem Bereich? Berührt übersetzter Tabellentext die nächste Spalte? Neusatz bedeutet, innerhalb voneinander abhängiger Bereiche eine lesbare Anordnung zu finden, statt Zeichen an alte Koordinaten zu kleben. Automatisch neu berechnete Spaltenbreiten, seitenübergreifend verschobene Grafiken oder eine neue Seiteneinteilung stellen wir nicht als garantierte Ergebnisse für jede Datei dar.
Das Ergebnis muss nicht pixelgenau dem Original entsprechen. Wichtiger ist, dass Überschriften und Haupttext unterscheidbar bleiben, Erklärungen zu Grafiken auffindbar sind und sich die ursprüngliche Argumentation weiterverfolgen lässt.
Abschließend Inhalt und Layout am Original prüfen
Eine ordentlich wirkende Seite muss nicht korrekt sein. Zu prüfen sind getrennt: fehlende oder doppelte Inhalte, falsche Zuordnungen sowie Überlagerungen, abgeschnittene Elemente und Reihenfolgefehler. Das sind Prüfdimensionen für das Ergebnis, keine Behauptung, das Werkzeug erledige bereits sämtliche inhaltlichen und visuellen Kontrollen automatisch.
Eine Grafik kann vollständig sichtbar sein, obwohl ihre Bildunterschrift nicht mehr eindeutig zugeordnet ist. Eine Formel kann vorhanden sein, aber falsch platzierte Indizes enthalten. Eine Tabelle kann ausgerichtet aussehen, während eine Zahl in die Nachbarspalte geraten ist. Solche Fehler findet man durch einen Abgleich von Inhalt und Struktur, nicht nur anhand eines abschließenden Screenshots.
Bei Zahlen, Begriffen, Formeln und Schlussfolgerungen bleibt das Original ein wichtiger Bezugspunkt. Layoutrekonstruktion erleichtert das Suchen und Prüfen, ersetzt aber nicht das Urteil der Lesenden über wesentliche Inhalte.
Unser Ziel ist ein lesbares Dokument, kein identisches Bild
„Wiederherstellen“ klingt leicht so, als müsse jedes Zeichen und jede Linie exakt an der ursprünglichen Stelle bleiben. Nach einem Sprachwechsel ist das nicht immer ein sinnvolles Ziel.
Wer die Übersetzung stark verkleinert, um die alte Zeilenzahl einzuhalten, oder Absätze zusammenquetscht, kann das Original optisch besser treffen und zugleich die Lesbarkeit verschlechtern. Angepasste Umbrüche, Schriftgrößen oder Zeilenabstände innerhalb des verfügbaren Bereichs können dagegen das Weiterlesen erleichtern – solange die Beziehungen zwischen Überschriften, Grafiken, Formeln und Erklärungen klar bleiben.
Uns interessieren deshalb vor allem praktische Fragen:
- Ist der Inhalt vollständig erhalten?
- Ist die Lesereihenfolge klar?
- Passen Grafiken, Formeln und Haupttext weiterhin zusammen?
- Können Lesende bei Bedarf zum Original zurückkehren und vergleichen?
- Eignet sich die Seite weiterhin zum tatsächlichen Lesen?
An diesem Problem möchte iSomor arbeiten. Wir wollen eine PDF nicht in eine Kette übersetzter Sätze verwandeln, sondern möglichst als Unterlage erhalten, die man lesen, gezielt durchsuchen und weiterverwenden kann.
Komplexe Dateien müssen weiterhin geprüft werden
PDFs unterscheiden sich stark nach Herkunft und Erstellung. iSomor richtet sich derzeit an PDFs mit extrahierbarem Text; OCR für ganzseitige Scans gehört nicht zum aktuell verfügbaren Funktionsumfang. Auch bei Text-PDFs können verschachtelte Tabellen, spezielle Schriftarten oder in Bilder eingebettete Texte die Grenzen automatischer Verarbeitung überschreiten.
Nach der Übersetzung lohnt es sich deshalb weiterhin, besonders wichtige Zahlen, Formeln, Diagramme und Schlussfolgerungen mit dem Original abzugleichen. Ein ordentliches Layout ist für uns kein Beweis dafür, dass der Inhalt vollständig korrekt ist.
Der Sinn unserer technischen Arbeit ist nicht, die Komplexität an die Lesenden weiterzureichen, sondern möglichst viele Unterbrechungen schon vorher abzufangen. Jedes ersparte Neuordnen und Suchen nach einer passenden Stelle gibt ihnen etwas mehr Raum, sich auf die Unterlage selbst zu konzentrieren.