
PDFの翻訳はなぜ難しいのか。私たちは何を再現しているのか?
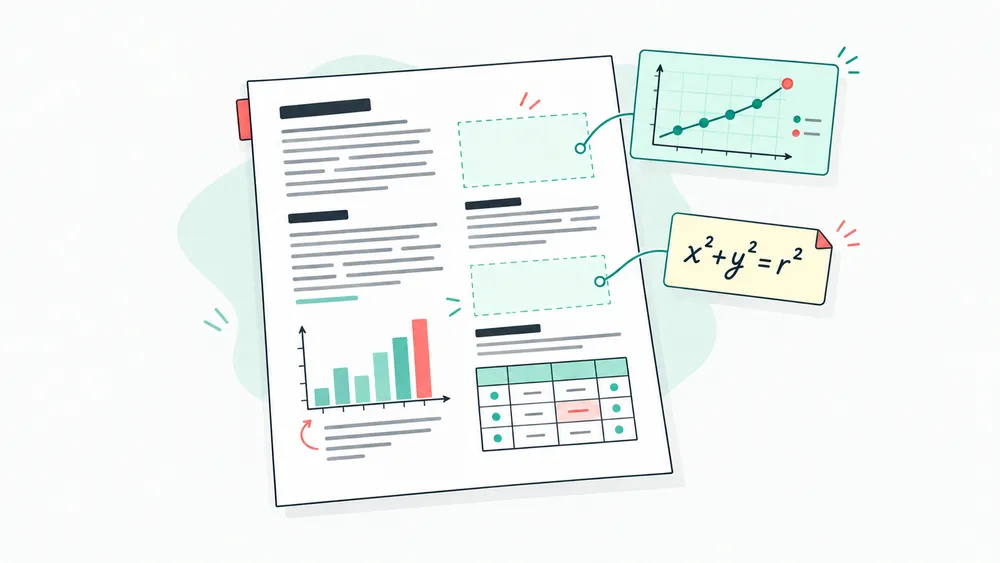
前回の記事「読み方から考える、PDFの翻訳で元のレイアウトを残す理由」では、読むときの習慣を手がかりに、PDFの翻訳で訳文だけを残すのでは不十分な理由を考えました。論文や報告書、技術資料を読むとき、私たちは見出しを見たり、図表を探したり、原文と訳文を行き来して確認したりします。元のレイアウトは、それらの内容のつながりを覚えておく助けになります。
ただし、そのつながりを技術的に保つのは簡単ではありません。
PDFの翻訳は、ある言語を別の言語に置き換えて、文字を元の位置に戻すだけの作業ではありません。ページが何で構成され、どの文字がひとまとまりなのかを判断し、訳文の長さが変わった後に配置を調整する必要もあります。
難しいのは、PDFが要素の「置かれている場所」は示していても、「何に属するか」まで示しているとは限らないことです。段落はどの見出しに属するのか、図表はどの説明に対応するのか、数式の記号はどの文で説明されているのか。こうした関係は、位置や書式、文脈から推定しなければならない場合があります。二段組み、図表、数式、表が加わると、その推定はさらに複雑になります。
PDFのページを、文字列としてそのまま読めない理由
文書を編集しているときは、見出しは見出し、段落は段落として扱われ、表の値がどの列に属するかも分かります。一方、PDFは「完成したページの見た目」に近い形式です。文字、線、画像、余白はそれぞれの場所に配置されていますが、明確な構造情報が付いているとは限りません。
一つの段落が多数の独立したテキストブロックに分かれていたり、グラフ内の文字と図形が別々に保存されていたりします。表も、行と列の情報を持たず、線と数字の集まりになっている場合があります。スキャンPDFでは、ページ自体が画像なので、文字、表、数式をまず画像から認識しなければなりません。
そのため、翻訳に入る前に、次のような問いに答える必要があります。
- どの文字が同じ段落に属するのか。
- どの見出しが、その下の内容に対応するのか。
- 二つの段をどの順序で読むのか。
- この説明はどの図や表に付いているのか。
- ヘッダーやフッターと本文をどう区別するのか。
こうした関係を理解せず、文字を抽出して順番に翻訳し、ページに戻すだけでは、すべての文が訳されていても、どこから読めばよいか分からない結果になりかねません。
つまり、PDF翻訳の最初の作業は文字の置き換えではなく、ページの構造をできるだけ理解することです。技術的には、単なる文字列の読み取りよりも、完成済みのページ上で「見出し・段落・図表・説明」の関係を組み直す作業に近いものです。
二段組みで本当に難しいのは、読む順序
論文や技術報告書では、二段組みがよく使われます。再現したいのは二本の縦長の領域ではなく、読者がページをたどる道筋です。どちらの段を先に読み、見出しはどこに属し、どこで脚注に目を移すのか、ということです。
人は左の段を読んでから右へ進むことをすぐ判断できても、処理システムにとって、文字の位置と読む順序は自動的に一致するものではありません。
段落が何行にも分かれ、各行が別々のテキストブロックとして認識されることがあります。座標や抽出順だけに従うと、左の段を読み終わる前に右へ飛ぶ、見出しが違う位置に入る、脚注が本文に割り込む、段をまたぐ図表を片方の段の一部と誤認する、といった問題が起こります。
技術的には、領域の分割、テキストブロックの並べ替え、途中に入る特殊な内容を、まとめて扱う必要があります。
- まず段と段の境界を判断する。
- 見出し、本文、脚注、ヘッダー、フッターを識別する。
- テキストブロック同士の前後関係を復元する。
- 翻訳後、利用可能な段幅の中で改行を調整する。
- 読者が元の順序に沿って読み進められるか確認する。
訳文が長くなると、元の領域に収まらないこともあります。各行の位置を無理に固定すれば、文字が重なったり、不自然な空白ができたりします。よい再現とは、一文字ずつ元の座標に置くことではなく、二段組みが作る読む順序をできるだけ保つことです。
図表は一枚の絵ではなく、つながった情報の集まり
図表は、PDF翻訳で難しさを見落とされがちな部分です。再現すべきなのは「似た見た目の画像」ではなく、図形、データ、凡例、キャプション、本文の対応関係です。
読者には、図と近くの文章が同じ説明の一部だと自然に分かります。しかしPDF内部では、それぞれが独立したオブジェクトで、異なるコンテンツレイヤーにある場合もあります。
本文がすべて訳されても、グラフのタイトル、軸、凡例、注記が未処理なら、著者の説明を理解できないことがあります。逆に、図の中の文字だけを訳して、本文やキャプションとの対応を保たなければ、関連する情報が切り離されてしまいます。
図には通常、いくつかの情報の層があります。
- 何を扱う図かを示すタイトル。
- 数値の読み方を示す軸と単位。
- 色、線、記号の意味を説明する凡例。
- 結果や変化を示す図中の注記。
- 条件や解釈を補うキャプションと本文中の参照。
これらは一体として扱う必要があります。システムは「近くにある」という条件だけではなく、その関係を判断しなければなりません。
- キャプションは図の下だけでなく、改ページによって次のページにあることもあります。
- 二段組みでは、最も近い段落が図の説明とは限りません。
- 本文の「図2参照」が、離れた位置の図を指すことがあります。
- 図中の文字は抽出可能なテキストの場合も、図形と一体化した画像の場合もあります。
- 軸、凡例、データラベルは翻訳が必要でも、数値やデータ同士の関係は変えてはいけません。
翻訳では、抽出できた文だけを訳すのではなく、データ、図形、説明の関係をできるだけ残す必要があります。つまり「ここに文字がある」だけでなく、「その文字が図の中でどんな役割を持つか」を判断することが求められます。
そのため、文字が訳されているかだけでは、図表を正しく再現できたかは判断できません。凡例は合っているか、単位が抜けていないか、キャプションを見つけられるか、本文の「図2」は本当にその図を指しているか。どれか一つでも対応が崩れると、図が残っていても、読者が受け取る意味は変わってしまいます。
数式で難しいのは、その周囲との関係
数式自体は通常、翻訳する必要がありません。再現すべきなのは周囲の文章との関係です。変数の説明、数式番号への参照、前後に書かれた条件を保つことが重要になります。
変数の説明が次の段落にあり、数式番号が本文から参照され、前後の条件が結論の成立を左右する場合があります。式だけを残しても、変数の説明や番号、文脈との対応がなくなれば、利用するのは難しくなります。
技術的には、数式の保存形式もさまざまです。文字とベクターの線を組み合わせたものもあれば、すでに画像となり、元のエディターの数式構造を持たないものもあります。抽出時に上付き・下付き文字、根号、ギリシャ文字が分かれたり混同されたりすることがあります。再配置でも、普通の文のように自由な位置で改行できません。式、番号、本文中の参照は対応させる必要があり、位置や順序の誤りで「式(3)」が別の式だと受け取られてはいけません。
少なくとも、次の点を確認する必要があります。
- 記号、上付き・下付き文字、特殊文字が欠けていないか。
- 数式番号と本文の参照が一致しているか。
- 変数の説明が関連する箇所の近くにあるか。
- 改行後も数式が読みやすいか。
- 周囲の説明文が誤って分断されていないか。
論文や技術資料では、数式が「見た目上残っている」ことは最低限の確認にすぎません。前後の文章との関係も同じように大切です。
表では、一つの位置ずれが数字の意味を変える
表で再現するのは枠線そのものではなく、行、列、見出し、単位、注記、数値の関係です。数字は正しい行と列、見出し、単位と組み合わさって初めて十分な意味を持ちます。
実際の文書には、結合セル、ページをまたぐ見出し、罫線のない列、空白で位置をそろえただけの表もあります。翻訳で一つのセルの文が長くなると、列全体の幅に影響します。元の座標に戻すだけでは、文字がはみ出したり隣の列を覆ったりして、数字が別の行に属すると誤解されることがあります。
したがって、表の再現で守るべきなのは、行列の関係、見出しの階層、単位、注記です。同じ位置に線を引き直すだけではありません。
訳文が長くなると、ページのバランスも変わる
ページ構造を正しく認識しても、翻訳後には別の問題が残ります。同じ意味を表すのに必要な空間は、言語によって異なります。ここで保ちたいのは文字ごとの座標ではなく、見出し、段落、図表、数式の分かりやすい位置関係です。
例えば英語の段落を中国語にすると短くなる場合もあれば、専門用語や括弧、説明によって長くなる場合もあります。言語が変われば、単語をどこで区切れるか、句読点をどう配置するか、フォントの幅がどう変わるかも、仕上がりに影響します。
その結果、次のような点が変わります。
- 二段組みの改行位置。
- 見出しが二行になるかどうか。
- 図表の脇に残る空間。
- 表の文字がセルからはみ出さないか。
- 元の領域に訳文全体が収まるか。
翻訳後の組版は、元のテキストボックスに訳文を貼り付けるだけでは成立しません。構造の近さと読みやすさのバランスが必要です。
私たちは、こうした関係をどう保とうとしているのか
iSomorでは、レイアウトの再現を最後に付け足す装飾ではなく、翻訳処理の一部と考えています。現在は抽出可能な文字を含むPDFを対象に、レイアウト認識、段落の構成、翻訳、訳文の配置をつなげて処理しています。以下は、何を扱い、結果の有用性をどう判断するかを説明するものです。複雑な関係をすべて自動で認識・検証できるという意味ではありません。
まず、意味のある内容の単位を見分ける
ページの解析では、文字の位置とレイアウト領域を組み合わせ、本文、見出し、図表、数式などをできるだけ区別し、翻訳する段落を構成します。目的は細かく切り分けることではなく、つながるはずの文章の分断や、別領域の文字の混在を減らすことです。
具体例が表です。実装ではセルの領域情報を後段の段落グループ化に利用し、同じセルの複数行はなるべく一緒に扱い、別セルの内容が混ざらないようにしています。ただし、すべての表を正確に再構築できるわけではありません。罫線のない表、複雑な見出し、セル内の複数段落では、グループ化を誤ることがあり、引き続き確認が必要です。
関連する情報を、できるだけ離さない
図表の認識だけでは不十分です。キャプション、凡例、本文中の参照が対応しているかも、結果の有用性を左右します。数式も、番号や変数の説明とのつながりを失ってはいけません。
これはまず再現の目標であって、システムがすべての参照関係を理解しているという約束ではありません。元の図形や番号、近くの文章の位置関係を残すことは、読者の照合を助けます。ただし、ページをまたぐキャプション、離れた参照、画像に組み込まれた文字については、ページが整って見えるだけで正しく処理されたとは判断できません。
段落の中で必要な文脈を保つ
現在の翻訳処理は、各行を独立した文として扱うのではなく、段落を単位としています。段落をできるだけ正しく構成することで、文が途中で切れて文脈を失う問題を減らせます。
ただし、段落をまとめても、文書全体の用語統一が自動的に保証されるわけではありません。同じ用語が見出し、本文、凡例、表で異なる訳になることもあり、別の領域に分かれている場合は特に注意が必要です。重要な用語や結論は原文と照合し、翻訳完了を全文の一貫性チェック完了と同じには捉えないことを勧めます。
訳文に合わせて使える空間を計算し直す
文字数が変われば、利用可能な領域に合わせて改行や配置を調整しつつ、図表や数式をできるだけ保つ必要があります。難しいのは、一つの段落が収まっても、隣の領域と干渉しないとは限らないことです。
見出しが二行になって下の文章を圧迫していないか、長くなったキャプションが領域を超えていないか、表の訳文が隣の列に触れていないか。再配置は、互いに制約し合う領域の中で読みやすい形を探す作業です。元の座標に文字を戻すだけではなく、段幅の自動再構築、図表のページ間移動、改ページの再計算が、すべての文書で実現するともしていません。
結果は元のファイルとピクセル単位で一致するとは限りません。それより重要なのは、見出しと本文を区別し、図表の説明を見つけ、元の論旨に沿って読み進められることです。
最後は原文に戻り、内容と配置を確かめる
整ったページだからといって、内容が正しいとは限りません。確認では、欠落や重複、対応関係の誤り、重なり・切れ・順序の問題を分けて見る必要があります。これは結果を評価する観点であり、すべての内容・視覚検証をツールが自動で済ませているという意味ではありません。
図は完全に残っていても、キャプションとの対応が曖昧かもしれません。数式はあっても、上付きや下付きの位置が違うかもしれません。表はそろって見えても、数字が隣の列に移っているかもしれません。こうした問題は、最後のスクリーンショットだけではなく、内容と構造を照合して見つける必要があります。
数値、用語、数式、結論を確認する際、原文は今も重要な参照先です。レイアウトの再現は探す手間や照合の負担を減らせますが、重要な内容についての読者の判断を代わりに行うものではありません。
目指すのは、同じ画像ではなく、読み続けられる文書
「再現」という言葉から、すべての文字や線を元と同じ場所に置くことを想像しがちです。しかし言語が変わった後では、その目標が合理的とは限りません。
元の行数に合わせるために文字を極端に小さくしたり、段落を詰め込んだりすれば、見た目は近づいても読みにくくなります。逆に、使える領域内で改行、文字サイズ、行間を適度に調整し、見出し、図表、数式、説明のつながりが明確なら、読み進めやすくなることがあります。
そのため、私たちは次のような実際的な点を重視しています。
- 内容が欠けずに残っているか。
- 読む順序が明確か。
- 図表、数式、本文が対応しているか。
- 必要なときに原文へ戻って照合できるか。
- 実際の読書に使えるページになっているか。
これがiSomorの取り組みたい課題です。PDFを翻訳済みの文の列に変えるのではなく、読んだり、調べたり、その先も使い続けたりできる資料として残したいと考えています。
複雑なファイルには、引き続き確認が必要
PDFは作成元や作り方によって大きく異なります。iSomorが現在対象とするのは、抽出可能な文字を含むPDFです。全面スキャン画像に必要なOCRは、現在提供している機能の範囲外です。文字を含むPDFでも、複雑な入れ子の表、特殊なフォント、画像に組み込まれた文字は、自動処理の限界を超えることがあります。
翻訳後も、特に論文の重要な数値、数式、図表、結論は原文で確認する価値があります。整ったレイアウトを、内容が完全に正しい証拠とは考えていません。
私たちにとって技術の役割は、複雑さを読者に渡すことではなく、読む流れを妨げる部分をできるだけ先に処理することです。整理し直す手間や対応箇所を探す手間が一つ減るたびに、読者は資料そのものへ注意を戻しやすくなります。