
PDF-ஐ உரையாக (TXT) மாற்றுவது எப்படி, அதன் பிறகு எதைச் சரிபார்க்க வேண்டும்
PDF-ஐ உரையாக மாற்ற, அந்த PDF-இல் உரை அடுக்கு (text layer) இருக்க வேண்டும்: கருவி கோப்பில் சேமிக்கப்பட்ட சொற்களை எடுக்கிறது, பக்கத்தின் படத்தை அல்ல. தேவையான பக்கங்களை மட்டும் TXT கோப்பாகப் பிரித்தெடுத்து, மூலத்துடன் ஒப்பிட்டு ஆறு விஷயங்களைச் சரிபாருங்கள்: வெற்றுப் பக்கங்கள், நெடுவரிசை வரிசை, தலைப்பு–அடிக்குறிப்பு வரிகளும் பக்க எண்களும், அட்டவணைகள், சூத்திரங்களும் குறியீடுகளும், சிதைந்த எழுத்துகள். வரிசை சரியான பிறகு, கடைசியாக வரி முறிவுகளைச் சீராக்குங்கள். குறிப்பெடுக்க, மேற்கோள் காட்ட, நீண்ட கையேட்டை உரை எடிட்டரில் தேட, அல்லது ஒரு பகுதியை வேறு ஆவணத்தில் பயன்படுத்த TXT கோப்பு உதவும். ஆனால் அது பக்கத்தின் நகல் அல்ல: எழுத்துருக்கள், படங்கள், நெடுவரிசைகள், அட்டவணைக் கோடுகள் மறைந்துவிடும்; சொற்களின் வரிசை அந்த PDF எப்படி உருவாக்கப்பட்டது என்பதைப் பொறுத்தது.
PDF-ஐ உரையாக மாற்றினால் என்ன கிடைக்கும்?
வெற்று உரைக் கோப்பில் எழுத்துகளும் வரி முறிவுகளும் மட்டுமே இருக்கும். மாற்றும்போது, கோப்பில் உரையாகச் சேமிக்கப்பட்ட ஒவ்வொரு சொல்லும் படிக்கப்பட்டு, ஒன்றன்பின் ஒன்றாக எழுதப்படுகிறது. தடித்த தலைப்புகள் சாதாரண வரிகளாகின்றன, அட்டவணைகள் சொற்களும் எண்களும் கொண்ட வரிசைகளாகின்றன, படங்கள் மறைகின்றன.
பலரை வியப்பில் ஆழ்த்துவது வரிசைதான். ஒவ்வொரு உரைத் துண்டும் பக்கத்தில் எங்கே வரையப்படுகிறது என்பதை PDF பதிவு செய்கிறது; அடுத்து எந்தப் பத்தி வரும் என்பதைப் பதிவு செய்ய வேண்டிய கட்டாயமில்லை. PyMuPDF ஆவணம் இதைத் தெளிவாகச் சொல்கிறது: வெற்று உரைப் பிரித்தெடுப்பு முடிவை அழகுபடுத்த முயலாது; PDF-இல் இதன் பொருள் "output not in usual reading order, unexpected line breaks and so forth", அதாவது வழக்கமில்லாத வாசிப்பு வரிசையும் எதிர்பாராத வரி முறிவுகளும் வரலாம் (PyMuPDF உரை வழிமுறைகள், ஆங்கிலம்). எனவே TXT-இல் எல்லாச் சொற்களும் இருந்தாலும், படிக்கும்போது வரிசை தவறாக இருக்கலாம்.
உங்கள் PDF-இல் பிரித்தெடுக்கக்கூடிய உரை இருக்கிறதா?
மாற்றுவதற்கு முன், PDF-ஐத் திறந்து கர்சரால் ஒரு வாக்கியத்தைத் தேர்ந்தெடுத்துப் பாருங்கள்.
- சொற்கள் ஒவ்வொன்றாகத் தேர்வாகின்றன: அந்தப் பக்கத்தில் உரை அடுக்கு உள்ளது; கருவியால் அதைப் படிக்க முடியும்.
- ஒரு வாக்கியத்தைக்கூடத் தேர்ந்தெடுக்க முடியவில்லை: அந்தப் பக்கத்தில் உரை அடுக்கு இல்லாமல் இருக்கலாம். அங்கே படிக்க எதுவும் இல்லை; iSomor-இன் PDF இலிருந்து உரை கருவி OCR செய்வதில்லை. உறுதியாகத் தெரியவில்லை என்றால் நேரடியாகப் பிரித்தெடுத்துப் பாருங்கள்; படிக்கக்கூடிய உரை இல்லாத பக்கங்கள் பட்டியலிடப்படும்.
- வியூவர் கடவுச்சொல் கேட்கிறது அல்லது நகலெடுக்க அனுமதி இல்லை என்கிறது: ஆவணம் பாதுகாக்கப்பட்டுள்ளது. நீங்கள் செயலாக்க அனுமதி உள்ள, பாதுகாப்பு இல்லாத நகலை உரிமையாளரிடம் கேளுங்கள்.
ஒரே ஆவணத்தில் இரண்டு வகைப் பக்கங்களும் இருக்கலாம்; உதாரணமாக, கையொப்பமிட்ட சில பக்கங்களின் படங்கள் சேர்க்கப்பட்ட அறிக்கை. அப்படிப்பட்ட பக்கங்களிலிருந்து உரை வராதது இயல்பானதே.
PDF-ஐ TXT ஆகப் படிப்படியாக மாற்றுவது எப்படி?
கீழே உள்ள படிகள் iSomor-இன் PDF இலிருந்து உரை கருவியை அடிப்படையாகக் கொண்டவை. அது உங்கள் உலாவியிலேயே PDF-இல் உள்ள உரை அடுக்கைப் படித்து, உரையை எடுப்பதற்கு முன் ஒவ்வொரு பக்கத்தையும் சரிபார்க்க உதவுகிறது.
- ஒரு PDF-ஐத் தேர்ந்தெடுங்கள். ஒரு நேரத்தில் உரை உள்ள ஒரு PDF மட்டும், அதிகபட்சம் 20 MB, 200 பக்கங்கள். 200 பக்கங்களுக்கு மேற்பட்ட கோப்பு, அதில் சில பக்கங்கள் மட்டுமே தேவைப்பட்டாலும், ஏற்கப்படாது. கோப்பு உங்கள் உலாவியிலேயே செயலாக்கப்படுகிறது; பதிவேற்றப்படுவதில்லை.
- தேவையான பக்கங்களை உள்ளிடுங்கள். எல்லாப் பக்கங்களுக்கும் பக்க வரம்பைக் காலியாக விடுங்கள், அல்லது
1-3, 5போன்ற வரம்பை எழுதுங்கள். பக்க எண்கள் அட்டைப் பக்கம் உட்பட, கோப்பில் 1 முதல் எண்ணப்படும் நிலைகள்; எனவே பக்கங்களில் அச்சிட்ட எண்களிலிருந்து வேறுபடலாம். ஓர் அத்தியாயம் மட்டும் தேவை என்றால் அதை மட்டும் பிரித்தெடுங்கள்; சரிபார்க்க வேண்டியது குறையும். - பக்கம் பக்கமாக முன்னோட்டம் பாருங்கள். பக்கங்களை ஒவ்வொன்றாகப் புரட்டி மூலத்துடன் ஒப்பிடுங்கள். தேர்ந்தெடுத்த பக்கங்களில் சிலவற்றில் படிக்கக்கூடிய உரை இல்லை என்றால், அவற்றின் பக்க எண்கள் பட்டியலிடப்படும்; மறைந்த அடுக்குகளின் உரை தவிர்க்கப்பட்ட பக்கங்களும் காட்டப்படும் (PDF வியூவரைப் போலவே, இயல்பாக மறைக்கப்பட்ட அடுக்குகளின் உரை பிரித்தெடுக்கப்படாது). தேர்ந்தெடுத்த எந்தப் பக்கத்திலும் படிக்கக்கூடிய உரை இல்லை என்றால், தேர்ந்தெடுத்த பக்கங்களில் படிக்கக்கூடிய உரை இல்லை என்று கருவி தெரிவிக்கும்; TXT கோப்பு உருவாக்கப்படாது.
- நகலெடுங்கள் அல்லது பதிவிறக்குங்கள். பிரித்தெடுத்த முழு உரையையும் நகலெடுக்கலாம், அல்லது TXT கோப்பாகப் பதிவிறக்கலாம். நகலெடுத்த உரையிலும் TXT கோப்பிலும் ஒவ்வொரு இரண்டு பக்கங்களுக்கும் இடையில் ஒரு பக்க முறிவு எழுத்து (form feed) இருக்கும்; எனவே பக்க எல்லைகள் தெரியும். TXT கோப்பு UTF-8 குறியாக்கத்தில், LF வரி முடிவுகளுடன் சேமிக்கப்படுகிறது.
ஒரு பக்கத்துக்கு அதிகபட்சம் 2,00,000 எழுத்துகள், மொத்தம் 10 லட்சம் எழுத்துகள் வரை கருவி கையாளும். மிக நீண்ட ஆவணத்தைப் பகுதி பகுதியாக மாற்றுங்கள்.
TXT-ஐப் பயன்படுத்தும் முன் எதைச் சரிபார்க்க வேண்டும்?
மூல PDF-ஐ உரைக்கு அருகில் திறந்து வைத்து, முதலில் இந்த இடங்களைப் பாருங்கள். பிரித்தெடுத்த உரையில் அடிக்கடி தவறு நிகழ்வது இங்குதான்; ஒவ்வொன்றுக்கும் தீர்வு வேறு.
| எதைச் சரிபார்க்க | TXT-இல் எப்படித் தெரியும் | என்ன செய்வது |
|---|---|---|
| வெற்றுப் பக்கங்கள் | ஒரு பக்க எண் படிக்கக்கூடிய உரை இல்லாத பக்கமாகப் பட்டியலிடப்படுகிறது, அல்லது தேர்ந்தெடுத்த பக்கங்களில் உரை இல்லை என்ற செய்தி வருகிறது | அந்தப் பக்கம் படமா என்று பாருங்கள். கோப்பே பழுதாகிவிட்டது என்று முடிவு செய்யாதீர்கள்; மற்ற பக்கங்கள் சரியாக இருக்கலாம். |
| நெடுவரிசை வரிசை | இடது நெடுவரிசையின் அரை வாக்கியம் வலது நெடுவரிசையின் அரை வாக்கியத்துடன் சேர்கிறது | சிறிய வரம்பைப் பிரித்தெடுத்துப் பக்கத்துடன் ஒப்பிடுங்கள். இப்போதே வரி முறிவுகளை நீக்காதீர்கள்; அது சிக்கலை மறைக்கும் அவ்வளவுதான். |
| தலைப்பு, அடிக்குறிப்பு வரிகள், பக்க எண்கள் | பத்தியின் நடுவில் ஒரு தொடர் தலைப்பு அல்லது பக்க எண் | பக்கத்துடன் ஒப்பிட்டு உறுதிசெய்த வரிகளை மட்டும் நீக்குங்கள். தனி வரியில் உள்ள எண் பிரிவு எண்ணாகவோ தரவாகவோ இருக்கலாம். |
| அட்டவணைகள் | கலங்கள் சொற்களும் எண்களும் கொண்ட தொடராக மாறுகின்றன; சில நேரம் வரிசையும் மாறுகிறது | எந்த எண்ணையும் பயன்படுத்தும் முன் மூலத்தைப் பார்த்து வரிசைகளை மீண்டும் அமையுங்கள். எண்களை மட்டுமல்ல, தலைப்புகளையும் அலகுகளையும் சரிபாருங்கள். |
| சூத்திரங்கள், குறியீடுகள் | மேலெழுத்து, கீழெழுத்து, பின்னங்கள், கழித்தல் குறி, கிரேக்க எழுத்துகள் தட்டையாகின்றன அல்லது காணாமல் போகின்றன | சூத்திரங்களை மூலத்திலிருந்து கையால் எழுதுங்கள், அல்லது பக்கத்தைக் குறிப்பிடுங்கள். |
| சிதைந்த எழுத்துகள் | PDF சரியாகத் தெரிந்தாலும் TXT-இல் சதுரங்கள், கேள்விக்குறிகள், தவறான எழுத்துகள் | இது கோப்பில் எழுத்துரு குறியாக்கம் செய்யப்பட்ட விதத்தால் வருகிறது. வரி முறிவுகளைச் சீராக்குவதால் இது சரியாகாது; அந்த ஆவணத்தின் வேறொரு ஏற்றுமதிப் பதிப்பைத் தேடுங்கள். |
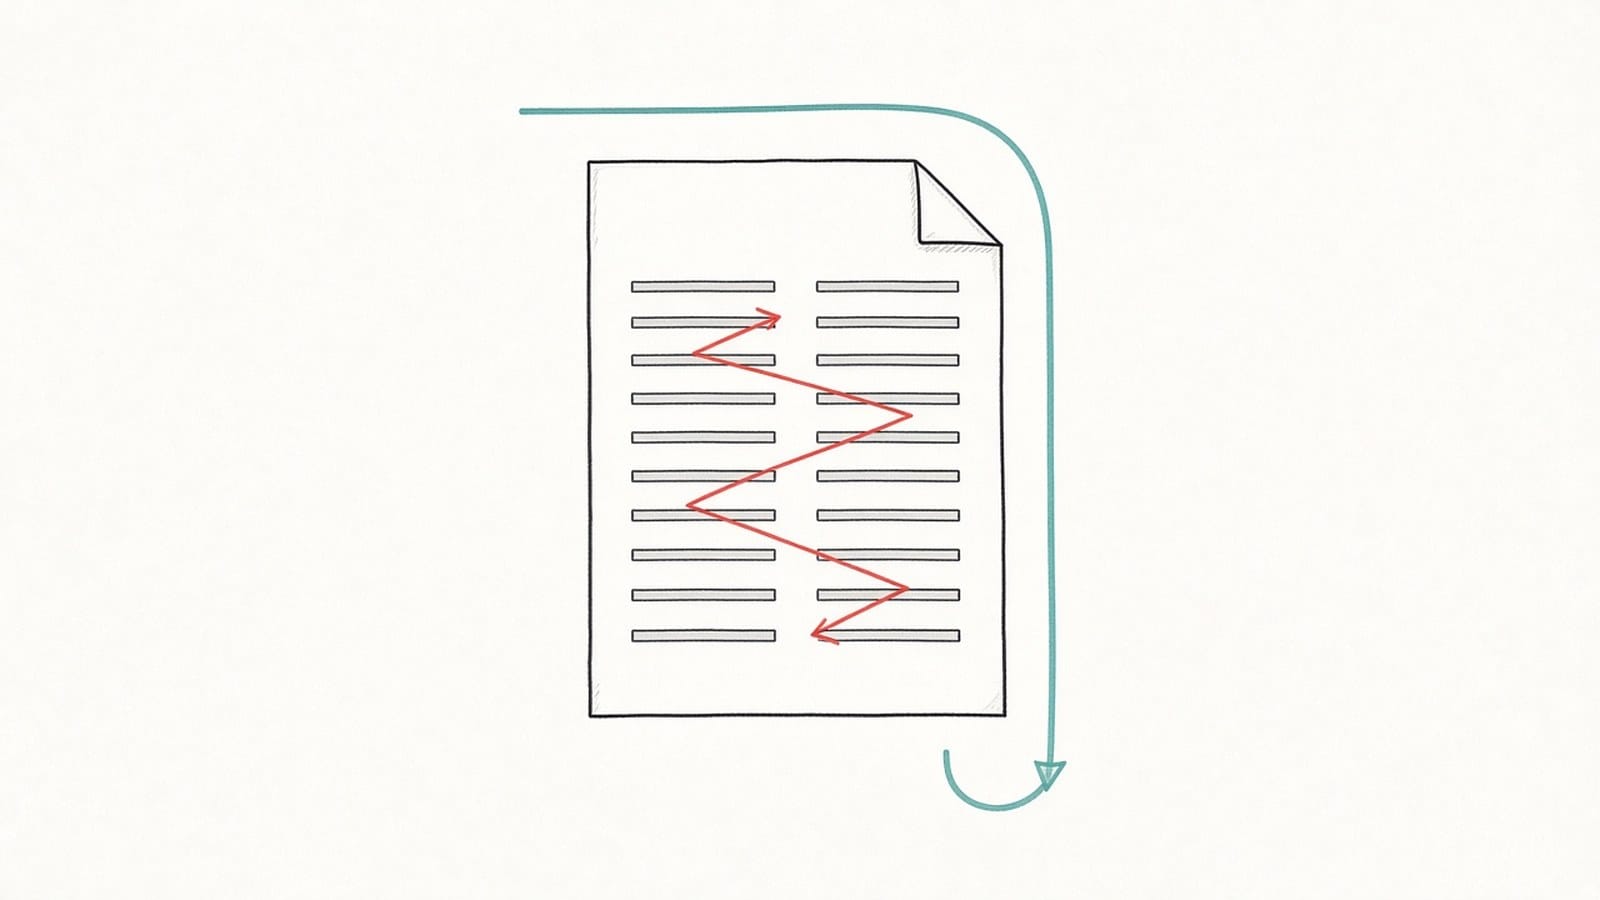
நெடுவரிசைச் சிக்கலுக்குத் தனிக் காரணம் உண்டு. நீங்கள் பிரித்தெடுப்பதற்குப் பதிலாக மொழிபெயர்க்கிறீர்கள் என்றால், அதே காரணத்தால் இரு நெடுவரிசைக் கட்டுரைகளின் மொழிபெயர்ப்பும் வரிசை தவறி வரும்; இதைப் பற்றி இரு நெடுவரிசை PDF மொழிபெயர்ப்பில் வரிசை குழம்பியதா? விரிவாக விளக்குகிறது.
வரி முறிவுகளை எப்போது சீராக்க வேண்டும்?
வரிசை சரியான பிறகுதான். பிரித்தெடுத்த உரை பெரும்பாலும் அச்சிட்ட ஒவ்வொரு வரியின் முடிவிலும் வாக்கியத்தை உடைக்கிறது; எல்லாவற்றையும் ஒரேயடியாக இணைக்கத் தோன்றும். ஆனால் இரண்டு நெடுவரிசைகள் இன்னும் கலந்திருந்தாலோ, பத்தியின் நடுவில் அடிக்குறிப்பு வரி இருந்தாலோ, வரிகளை இணைப்பது தவறான துண்டுகளை ஒட்டவைக்கும் அவ்வளவுதான்.
வரிசை சரியாக இருந்தால், பத்திக்குள் உள்ள ஒற்றை வரி முறிவுகளை இணைத்து, பத்திகளுக்கு இடையேயான வெற்று வரிகளை வைத்துக்கொள்வது பொதுவாகப் பாதுகாப்பானது. தலைப்புகள், பட்டியல்கள், வரி முடிவில் உள்ள இணைப்புக்குறிகள் ஆகியவற்றுக்குத் தனிக் கவனம் தேவை. PDF-இலிருந்து நகலெடுத்த உரை ஏன் எப்போதும் குழப்பமாக வருகிறது? என்ற கட்டுரை iSomor உரைச் சீராக்கி மூலம் இந்த நிலைகளை உண்மையான முன்–பின் உதாரணங்களுடன் காட்டுகிறது.
வெற்று உரை எப்போது பொருத்தமான வடிவம் அல்ல?
மீண்டும் பயன்படுத்தச் சொற்கள் வேண்டும் என்றால் வெற்று உரை சரியான தேர்வு. ஆனால் தளவமைப்பே பொருளைத் தாங்கும்போது, உதாரணமாக வரிசை வரிசையாகப் படிக்க வேண்டிய அட்டவணை, தலைப்புக் குறிப்புடன் கூடிய படம், சூழலில் உள்ள சூத்திரம் போன்றவற்றுக்கு அது பொருந்தாது.
உங்கள் உண்மையான நோக்கம் வேற்று மொழி PDF-ஐப் படிப்பது என்றால், அதை TXT ஆக்கிப் பிறகு உரையை மொழிபெயர்ப்பது அந்தச் சூழலை இழக்கச் செய்யும். iSomor மூல உரை PDF-ஐயே நேரடியாக மொழிபெயர்த்து, பக்கத் தளவமைப்பை முடிந்தவரை பாதுகாக்கிறது; எனவே மொழிபெயர்ப்பை அதே இடத்தில் படிக்கலாம், அல்லது மூலமும் மொழிபெயர்ப்பும் பக்கவாட்டில் உள்ள இருமொழி PDF ஆகப் பார்க்கலாம். பக்கத்தில் எவை தங்குகின்றன என்பதை PDF ஐ மொழிபெயர்க்கும்போது iSomor அசல் தளவமைப்பைப் பாதுகாக்குமா? விளக்குகிறது.
அடிக்கடி கேட்கப்படும் கேள்விகள்
படிக்கக்கூடிய உரை இல்லை என்று கருவி ஏன் சொல்கிறது?
நீங்கள் தேர்ந்தெடுத்த எந்தப் பக்கத்திலும் கருவி படிக்கக்கூடிய உரை அடுக்கு இல்லை; அதனால் TXT கோப்பு உருவாக்கப்படவில்லை. அவை ஸ்கேன் செய்த பக்கங்களாகவோ படமாகச் சேமித்த பக்கங்களாகவோ இருக்கலாம். பிரித்தெடுக்கும் கருவி சேமிக்கப்பட்ட உரையைப் படிக்கிறது; படத்தில் உள்ள சொற்களை அடையாளம் காண்பதில்லை. முடிந்தால், மூல ஆவணத்திலிருந்து ஏற்றுமதி செய்த PDF-ஐக் கேளுங்கள்.
TXT கோப்பில் PDF-இன் தளவமைப்பு இருக்குமா?
இருக்காது. உரை PDF-இல் சேமிக்கப்பட்ட வரிசையைப் பின்பற்றுகிறது; எளிய வரி முறிவுகள் மட்டுமே மீண்டும் அமைக்கப்படுகின்றன. நெடுவரிசைகள், அட்டவணைகள், கணிதக் குறியீடுகள் குழம்பலாம்; அதனால்தான் மேலே உள்ள சரிபார்ப்புகள் முக்கியம்.
எந்தப் பக்க எண்களை உள்ளிட வேண்டும்?
அட்டைப் பக்கம் உட்பட, கோப்பில் 1 முதல் எண்ணப்படும் நிலைகளை உள்ளிடுங்கள். உதாரணமாக, 1-3, 5 என்பது முதல் மூன்று பக்கங்களையும் ஐந்தாவது பக்கத்தையும் தேர்ந்தெடுக்கும். ஒரு பக்கம் வரம்பில் இரண்டு முறை வந்தால், அது ஒரு முறை மட்டுமே, நீங்கள் எழுதிய வரிசையில் பிரித்தெடுக்கப்படும்.
பக்கங்களுக்கு இடையே உள்ள அந்த விசித்திரக் குறி என்ன?
நகலெடுத்த உரையும் TXT கோப்பும் பக்கங்களைப் பக்க முறிவு எழுத்தால் பிரிக்கின்றன. எடிட்டரைப் பொறுத்து, அது கண்ணுக்குத் தெரியாமல் இருக்கலாம், அல்லது சிறிய குறியாகவோ ^L ஆகவோ தெரியலாம். அதைப் பக்கக் குறியாக வைத்துக்கொள்ளலாம், அல்லது நீக்கலாம்.
கடவுச்சொல் பாதுகாப்புள்ள PDF-ஐ உரையாக மாற்ற முடியுமா?
iSomor-இன் PDF இலிருந்து உரை கருவியால் முடியாது. கடவுச்சொல் பாதுகாப்புள்ள PDF-களையும் நகலெடுக்க அனுமதி இல்லாத ஆவணங்களையும் அது திறப்பதில்லை. நீங்கள் செயலாக்க அனுமதி உள்ள, பாதுகாப்பு இல்லாத நகலைப் பயன்படுத்துங்கள்.
இலவசக் கருவி: PDF இலிருந்து உரை, உங்கள் உலாவியிலேயே உள்ளூரில் இயங்கும்