
怎样对照原文检查 PDF 译文:数字、术语和表格
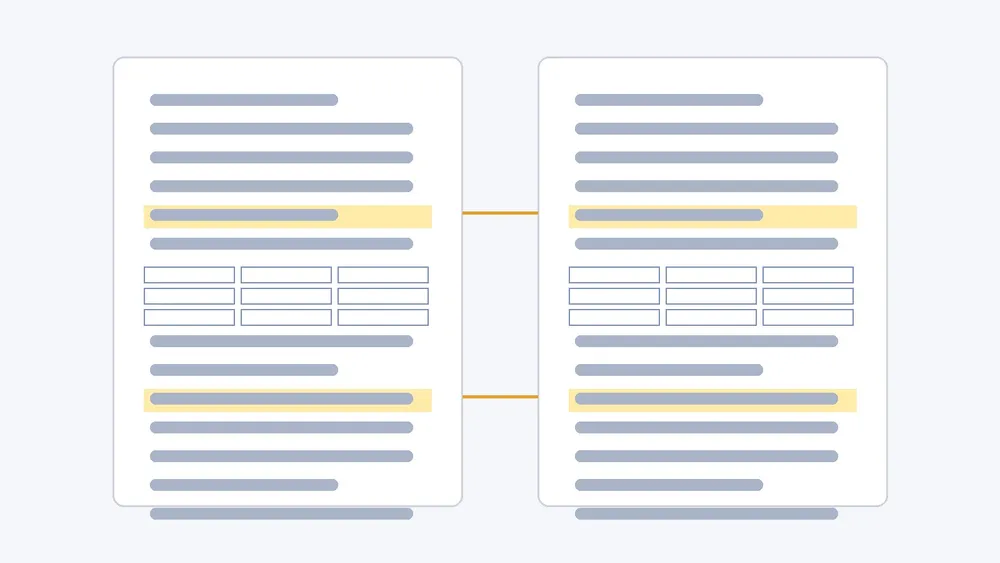
要对照原文检查 PDF 译文,最好把原文和译文放在同一份双语 PDF 里,然后分几轮看:先查数字和单位,再查术语和名称,接着查否定和条件,最后查表格和图表编号。 每一轮只找一类错误,这样才能抓到通读时被流畅句子掩盖的问题。本文讲的是怎么检查已有的译文;如果还没有双语文件,可以先看如何制作用于并排审阅的双语 PDF。
为什么只读译文不够
文档翻译出错,很少是读起来不对,而是读起来很顺、意思却悄悄变了:230 V 变成 220 V,"请勿拆卸"丢了"勿",表格的行标签错到下一行,型号里改了一个字母。只读目标语言时,这些错误都不显眼;把原文同一位置放在旁边一比,就看出来了。所以检查时原文必须一直可见。
准备对照环境
- 原文用电子版 PDF,译文要来自同一个文件、同一个版本。
- 把原文和译文放在一个屏幕上,左右并排或上下排列都可以。双语 PDF 把两种语言放在同一页,不用来回同步两个阅读器。
- 建一个简单的问题记录表,四列:页码、原文、译文、问题。发现问题就记下来,不要只在脑子里改。
- 先定检查范围。长文档里,含数字、表格或操作步骤的页逐页查,纯叙述的段落抽查。
第一轮:数字、单位和日期
在原文里逐个找出数字,再到译文里找对应的那一个。核对数值、单位、小数点、范围和公差、日期。有些写法在不同语言里本来就不同,比如 1,5 和 1.5,要确认写法变了、意思没变。原文里有、译文里找不到的数字,往往说明整句漏译了。
第二轮:术语、名称和编号
先列出文档里重要的词:产品和零件名称、界面按钮名称、定义过的术语、缩写,以及人名和机构名。检查同一个词是否每次都译得一样,型号、标准号、引文这类编号是否原样保留。原文里的标签如果对应真实界面或设备上的文字,在读者需要的地方保留原标签,方便对照。
第三轮:否定、条件和适用范围
在原文里搜那些会改变意思的小词:不、仅、除非、之前、之后、至少、最多、必须、可以。逐句对照,确认译文保留了同样的条件,而且条件作用在同一个对象上。警告和注意事项也要仍然紧挨着它所属的那一步。
第四轮:表格、公式和图表编号
版式错误最常藏在表格里。每张表都拿表头、第一列和一整行,跟原文逐格对照。确认正文里提到的图号、表号仍然指向正确的图表,图注没有离开它的图。公式多的页面,要核对符号、下标和正文引用的公式编号,具体可以看翻译含数学公式的 PDF。另外要记住,图片里的文字,比如截图或示意图上的标签,可能仍是原文语言。
发现问题之后怎么办
把记录按类型归类。个别误译直接改;如果是规律性问题,比如同一个术语有三种译法,就先定下统一译法,再把所有出现的地方都查一遍。如果问题出在文件本身,比如有扫描页或文字层损坏,要先处理原文 PDF,怎么判断可以看翻译扫描版 PDF 前要检查什么。涉及法律或安全后果的文档,要请合格的审校人员把关;这样检查过的机器翻译是阅读和审阅用的副本,不是认证翻译。
用 iSomor 做对照
在 iSomor 上传电子版 PDF、选择语言,就能把译文和原文左右并排或上下对照阅读。完成后可以下载只含译文的 PDF 用来阅读,也可以下载双语 PDF 用来核对和分享。iSomor 会尽量让表格、图表和图注、公式保留在原来的上下文中,分轮检查会更顺手;但名称、数字、专业术语和复杂版式仍然要对照原文检查。扫描件即使做过 OCR 也不支持。
常见问题
完整检查一遍要多久?
取决于文档里数字、表格和操作步骤有多少。含数字的页逐页查、纯叙述抽查,通常比把每句话平均读一遍更有用。
长 PDF 能只查一部分吗?
可以。你可以先只翻译 PDF 中选定的页面并检查这几页,借此先统一术语,再处理整份文件。
检查过的译文算认证翻译吗?
不算。仔细检查能让译文读起来更可靠,但认证是另一套流程,要由有资质的译者或机构完成。
左右并排和上下排列,哪种更适合检查?
大段文字适合左右并排。很宽的表格往往上下排列更好看,因为每一行都能完整显示。