
PDF 번역은 왜 어려울까요? 우리는 무엇을 복원하고 있을까요?
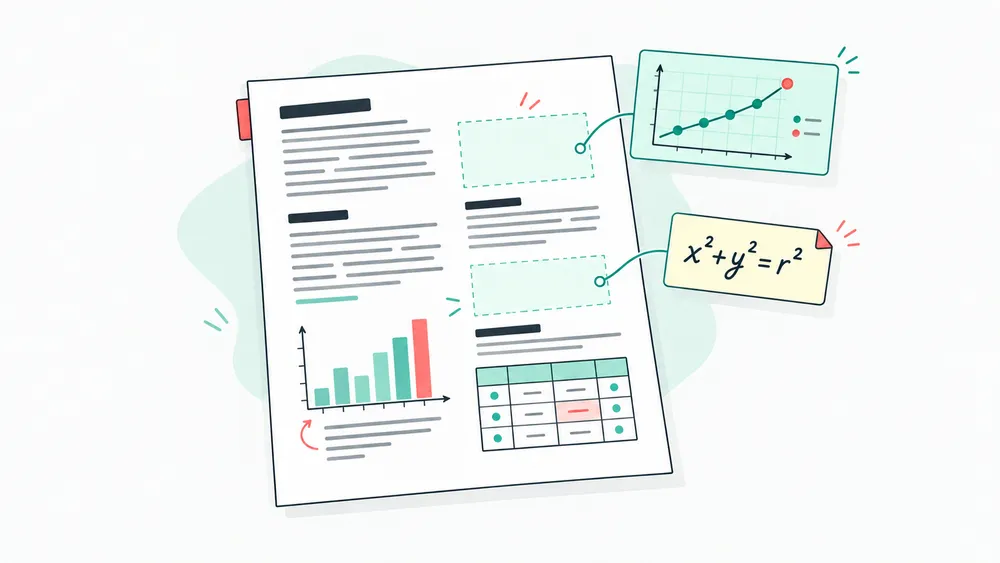
지난 글 「읽는 습관으로 살펴보는 PDF 번역에서 원래 레이아웃이 중요한 이유」에서는 읽는 습관을 바탕으로, PDF를 번역할 때 번역된 문장만 남겨서는 충분하지 않은 이유를 살펴봤습니다. 논문이나 보고서, 기술 자료를 읽을 때 우리는 제목을 훑고 도표를 찾으며 원문과 번역문을 오가면서 내용을 확인합니다. 원래의 레이아웃은 이 내용들이 어떻게 연결되는지 기억하는 데 도움을 줍니다. 하지만 이런 연결을 기술적으로 유지하는 일은 간단하지 않습니다. PDF 번역은 한 언어를 다른 언어로 바꾸고 글자를 원래 위치에 돌려놓는 작업만이 아닙니다. 페이지가 무엇으로 구성되는지 이해하고, 어떤 텍스트가 한 부분에 속하는지 판단하며, 번역문 길이가 달라지면 배치를 다시 조정해야 합니다. 어려운 점은 PDF가 요소의 ‘위치’는 알려 주어도 ‘어디에 속하는지’까지 알려 주지는 않을 수 있다는 데 있습니다. 문단이 어떤 제목에 속하는지, 도표가 어떤 설명과 연결되는지, 수식의 기호를 어느 문장이 설명
읽고 싶은 자료를 언어 때문에 포기하지 않도록
마침 필요하던 자료를 찾았습니다. 연구와 관련된 논문일 수도, 기술적인 문제를 설명하는 매뉴얼일 수도, 참고할 만한 설계안일 수도 있습니다. 특별히 자료를 찾고 있지 않았을 수도 있습니다. 우연히 본 논문의 제목에 끌렸거나, 다른 사람이 공유한 의견을 보고 저자가 실제로 어떻게 말했는지 궁금해진 경우도 있겠지요. 계속 읽고 싶은데, 충분히 익숙하지 않은 언어로 쓰여 있습니다. 전혀 이해할 수 없는 것은 아닙니다. 번역의 도움을 받으면 조금씩 읽을 수 있습니다. 다만 끝까지 읽으려면 시간을 더 내고, 자료와 여러 도구 사이를 오가야 합니다. 그래서 파일을 저장하고 나중에 읽으려 합니다. 그러다 아예 덮어 둔 채 다시는 열지 않을 수도 있습니다. 이런 추가 부담을 수치로 살펴본 연구도 있습니다. 2023년 PLOS Biology에 발표된 연구는 8개국의 환경과학 연구자 908명을 조사했습니다. 영어 논문을 한 편만 발표한 연구자를 기준으로 추정했을 때, 영어 숙련도가 중간인 국가
읽는 습관으로 살펴보는 PDF 번역에서 원래 레이아웃이 중요한 이유
외국어 보고서를 읽다가 낯선 문장을 만나면 복사해서 번역해 보곤 합니다. 몇 문장이라면 편리한 방법입니다. 하지만 문서 전체를 읽어야 할 때는 번역된 글자만으로 충분하지 않을 수 있습니다. 본문에서 언급한 그림은 어디에 있을까요? 이 숫자는 표의 어느 항목에 해당할까요? 방금 읽은 설명을 다시 찾으려면 어디로 가야 할까요? 이런 질문은 언어뿐 아니라 글이 원래 놓여 있던 위치와도 관련이 있습니다. 번역은 문장을 이해하도록 돕고, 원래 레이아웃은 그 문장이 문서 전체에서 어디에 속하는지 알려 줍니다. iSomor가 가능한 한 레이아웃을 유지하려는 이유도 여기에 있습니다. 언어가 바뀌어도 익숙한 방식으로 문서를 읽을 수 있기를 바랍니다. 우리는 늘 첫 줄부터 마지막 줄까지 읽지는 않습니다 수십 쪽짜리 자료를 열자마자 처음부터 한 글자씩 읽는 경우는 많지 않습니다. 목차와 소제목에서 관심 있는 부분을 찾기도 하고, 그림에 눈길이 가면 무엇을 설명하는지 알아보려고 본문으로 돌아가