
PDF in Text (TXT) umwandeln – und was Sie danach prüfen sollten
Um ein PDF in Text umzuwandeln, braucht das PDF eine Textebene: Das Werkzeug liest die in der Datei gespeicherten Wörter, kein Bild der Seite. Extrahieren Sie nur die Seiten, die Sie brauchen, als TXT-Datei und prüfen Sie sie anhand des Originals an sechs Stellen: leere Seiten, Spaltenfolge, Kopf- und Fußzeilen mit Seitenzahlen, Tabellen, Formeln und Sonderzeichen sowie falsch dargestellte Zeichen. Zeilenumbrüche bereinigen Sie zuletzt, wenn die Reihenfolge stimmt. Eine TXT-Datei eignet sich für Notizen, Zitate, die Suche in einem langen Handbuch per Texteditor oder um eine Passage in ein anderes Dokument zu übernehmen. Eine Kopie der Seite ist sie nicht: Schriften, Bilder, Spalten und Tabellenlinien fehlen, und die Reihenfolge der Wörter hängt davon ab, wie das PDF erstellt wurde.
Was bekommen Sie, wenn Sie ein PDF in Text umwandeln?
Eine reine Textdatei enthält Zeichen und Zeilenumbrüche, sonst nichts. Bei der Umwandlung wird jedes als Text gespeicherte Wort aus der Datei gelesen und hintereinander ausgegeben. Fette Überschriften werden zu normalen Zeilen, Tabellen zu Reihen aus Wörtern und Zahlen, Bilder verschwinden.
Überraschend ist meist die Reihenfolge. Ein PDF speichert, wo jedes Textstück auf der Seite gezeichnet wird, aber nicht unbedingt, welcher Absatz als Nächstes kommt. Die Dokumentation von PyMuPDF sagt es deutlich: Die reine Textextraktion verschönert das Ergebnis nicht, und bei PDFs kann das „output not in usual reading order, unexpected line breaks and so forth“ bedeuten, also eine ungewohnte Lesereihenfolge und unerwartete Zeilenumbrüche (PyMuPDF-Rezepte zur Textextraktion, englisch). Eine TXT-Datei kann also jedes Wort enthalten und sich trotzdem falsch lesen.
Enthält Ihr PDF überhaupt Text zum Extrahieren?
Öffnen Sie das PDF vor der Umwandlung und versuchen Sie, mit dem Cursor einen einzelnen Satz zu markieren.
- Die Wörter werden einzeln markiert: Die Seite hat eine Textebene, die ein Werkzeug auslesen kann.
- Sie können keinen Satz markieren: Die Seite hat wahrscheinlich keine Textebene. Dort gibt es nichts zu lesen, und das iSomor-Werkzeug „PDF in Text umwandeln“ führt keine OCR durch. Wenn Sie unsicher sind, starten Sie einfach die Extraktion; Seiten ohne lesbaren Text werden aufgelistet.
- Der Viewer verlangt ein Passwort oder meldet, dass Kopieren nicht erlaubt ist: Das Dokument ist geschützt. Bitten Sie den Eigentümer um eine ungeschützte Kopie, die Sie verarbeiten dürfen.
Ein Dokument kann beide Seitenarten mischen, etwa ein Bericht mit einigen eingefügten Bildern unterschriebener Seiten. Dass diese Seiten keinen Text liefern, ist normal.
Wie wandeln Sie ein PDF Schritt für Schritt in TXT um?
Die folgenden Schritte nutzen PDF in Text umwandeln von iSomor. Das Werkzeug liest die vorhandene Textebene im Browser und lässt Sie jede Seite prüfen, bevor Sie den Text übernehmen.
- Ein PDF auswählen. Verarbeitet wird jeweils ein PDF mit Textebene, bis 20 MB und 200 Seiten. Dateien mit mehr als 200 Seiten werden abgelehnt, auch wenn Sie nur wenige Seiten daraus brauchen. Die Datei wird im Browser verarbeitet und nicht hochgeladen.
- Seiten angeben. Lassen Sie den Seitenbereich leer für alle Seiten oder geben Sie einen Bereich wie
1-3, 5ein. Die Seitenzahlen sind Positionen in der Datei ab 1, das Deckblatt mitgezählt; sie können daher von den aufgedruckten Seitenzahlen abweichen. Brauchen Sie nur ein Kapitel, extrahieren Sie nur dieses – dann gibt es weniger zu prüfen. - Seite für Seite ansehen. Blättern Sie durch die Seiten und vergleichen Sie jede mit dem Original. Haben einige der gewählten Seiten keinen lesbaren Text, werden ihre Seitenzahlen aufgelistet, ebenso Seiten, auf denen Text in ausgeblendeten Ebenen übersprungen wurde (wie in einem PDF-Viewer wird Text aus standardmäßig ausgeblendeten Ebenen nicht extrahiert). Hat keine der gewählten Seiten lesbaren Text, meldet das Werkzeug, dass auf den gewählten Seiten kein lesbarer Text vorhanden ist, und erstellt keine TXT-Datei.
- Kopieren oder herunterladen. Kopieren Sie den gesamten Text oder laden Sie eine TXT-Datei herunter. Sowohl im kopierten Text als auch in der TXT-Datei steht zwischen je zwei Seiten ein Seitenvorschubzeichen, die Seitengrenzen bleiben also erhalten. Die TXT-Datei wird in UTF-8 mit LF-Zeilenenden gespeichert.
Pro Seite sind bis zu 200.000 Zeichen möglich, insgesamt bis zu 1 Million. Sehr lange Dokumente wandeln Sie am besten in Teilen um.
Was sollten Sie in der TXT-Datei prüfen, bevor Sie sie verwenden?
Öffnen Sie das Original-PDF neben dem Text und sehen Sie sich zuerst diese Stellen an. Hier geht bei extrahiertem Text am häufigsten etwas schief, und jede braucht eine andere Lösung.
| Was prüfen | So sieht es in der TXT aus | Was tun |
|---|---|---|
| Leere Seiten | Eine Seitenzahl wird als Seite ohne lesbaren Text gelistet, oder eine Meldung sagt, dass die gewählten Seiten keinen lesbaren Text haben | Prüfen Sie, ob die Seite ein Bild ist. Gehen Sie nicht davon aus, dass die Datei defekt ist; der Rest kann in Ordnung sein. |
| Spaltenfolge | Ein halber Satz aus der linken Spalte läuft in einen halben Satz aus der rechten | Einen kleineren Bereich extrahieren und mit der Seite vergleichen. Noch keine Zeilenumbrüche löschen – das verdeckt das Problem nur. |
| Kopf-, Fußzeilen, Seitenzahlen | Ein Kolumnentitel oder eine Seitenzahl mitten im Absatz | Nur Zeilen entfernen, die Sie mit der Seite abgeglichen haben. Eine Zahl in eigener Zeile kann eine Abschnittsnummer oder ein Datenwert sein. |
| Tabellen | Zellen werden zu einer Folge von Wörtern und Zahlen, manchmal in anderer Reihenfolge | Zeilen anhand des Originals wiederherstellen, bevor Sie eine Zahl verwenden. Auch Spaltenköpfe und Einheiten prüfen, nicht nur die Zahlen. |
| Formeln und Sonderzeichen | Hoch- und Tiefstellungen, Brüche, Minuszeichen oder griechische Buchstaben sind abgeflacht oder fehlen | Formeln von Hand aus dem Original übernehmen oder auf die Seite verweisen. |
| Falsche Zeichen | Kästchen, Fragezeichen oder falsche Buchstaben, obwohl das PDF normal aussieht | Ursache ist die Schriftkodierung in der Datei. Zeilenbereinigung hilft hier nicht; suchen Sie einen anderen Export des Dokuments. |
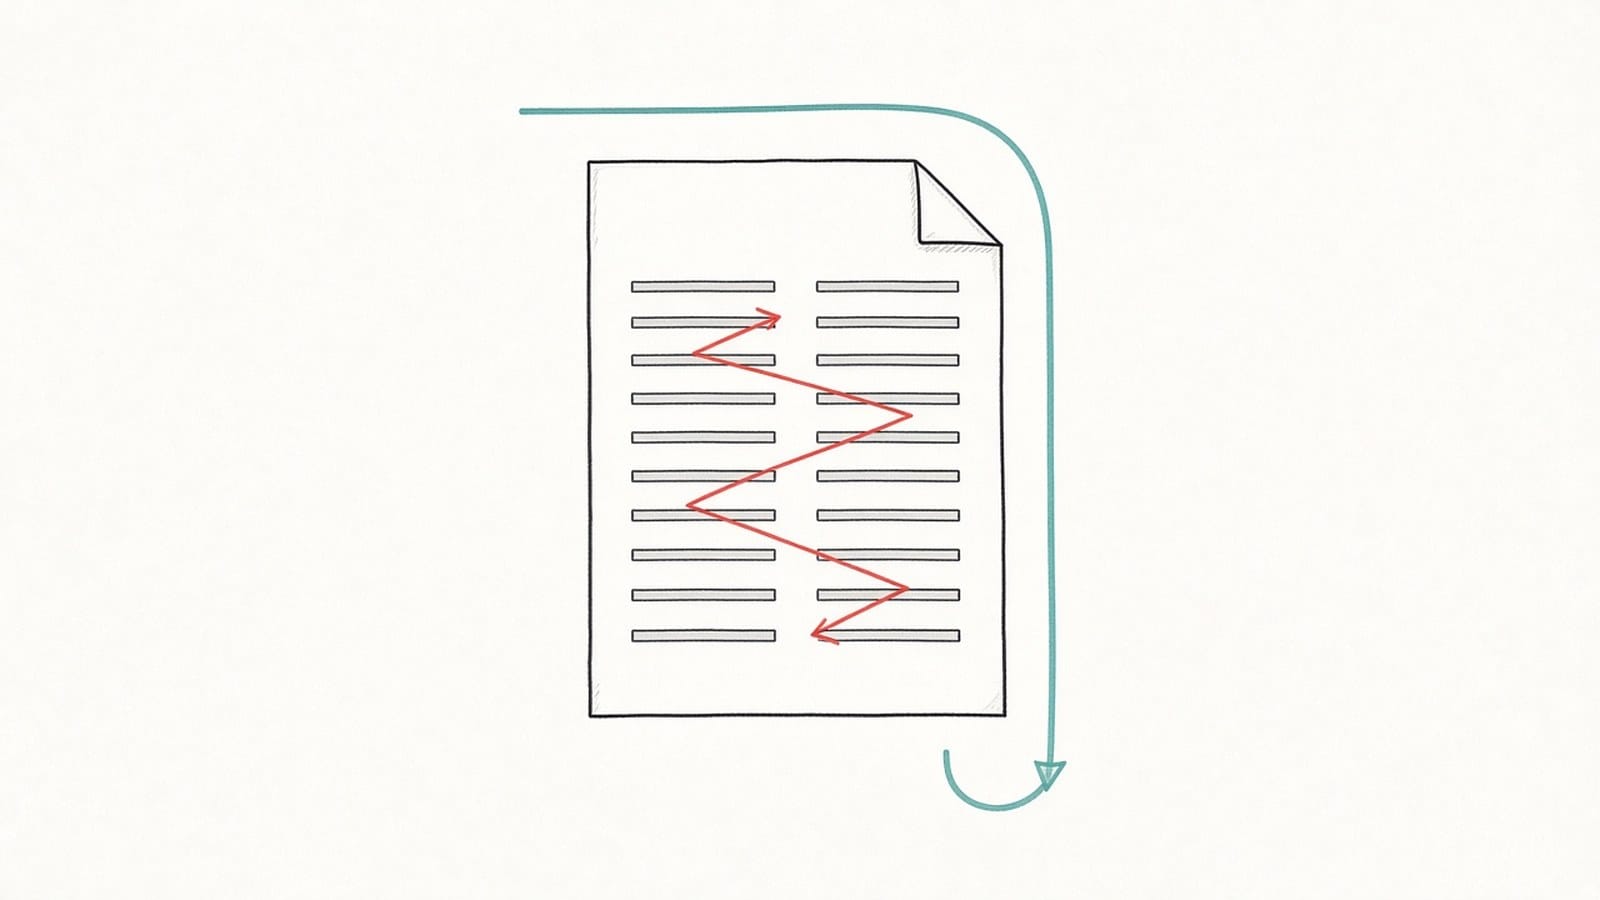
Das Spaltenproblem hat eine eigene Ursache. Wer übersetzt statt extrahiert, erlebt aus demselben Grund, dass übersetzte zweispaltige Artikel durcheinandergeraten – mehr dazu in Zweispaltiges PDF übersetzt und die Reihenfolge stimmt nicht?.
Wann sollten Sie Zeilenumbrüche bereinigen?
Erst wenn die Reihenfolge stimmt. Extrahierter Text bricht Sätze oft am Ende jeder gedruckten Zeile um, und es liegt nahe, alles auf einmal zusammenzufügen. Sind aber noch zwei Spalten vermischt oder steht eine Fußzeile mitten im Absatz, klebt das Zusammenfügen nur die falschen Stücke aneinander.
Stimmt die Reihenfolge, ist es meist unbedenklich, einfache Zeilenumbrüche innerhalb von Absätzen zu verbinden und Leerzeilen zwischen Absätzen zu behalten. Überschriften, Listen und Trennstriche am Zeilenende brauchen eigene Aufmerksamkeit. In Warum ist der aus einem PDF kopierte Text immer so unordentlich? sehen Sie diese Fälle mit echten Vorher-nachher-Beispielen, bearbeitet mit Text bereinigen von iSomor.
Wann ist reiner Text das falsche Format?
Reiner Text ist richtig, wenn Sie Wörter weiterverwenden wollen. Er ist falsch, wenn das Layout Bedeutung trägt: eine Tabelle, die Sie Zeile für Zeile lesen müssen, eine Abbildung mit Bildunterschrift oder eine Formel im Zusammenhang.
Wenn Sie eigentlich ein fremdsprachiges PDF lesen wollen, verlieren Sie diesen Zusammenhang, sobald Sie es erst in TXT umwandeln und dann den Text übersetzen. iSomor übersetzt stattdessen das ursprüngliche PDF mit Textebene und behält das Seitenlayout so weit wie möglich bei. Sie können die Übersetzung an Ort und Stelle lesen oder als zweisprachiges PDF zum direkten Vergleich. Was auf der Seite erhalten bleibt, steht in Behält iSomor beim Übersetzen das PDF-Layout bei?.
FAQ
Warum meldet das Werkzeug, dass kein lesbarer Text vorhanden ist?
Keine der gewählten Seiten hat eine Textebene, die das Werkzeug lesen kann, deshalb wird keine TXT-Datei erstellt. Wahrscheinlich handelt es sich um gescannte oder als Bild gespeicherte Seiten. Ein Textwerkzeug liest gespeicherten Text; Wörter in einem Bild erkennt es nicht. Fragen Sie nach Möglichkeit nach einem PDF, das direkt aus dem Originaldokument exportiert wurde.
Behält die TXT-Datei das Layout des PDFs?
Nein. Der Text folgt der im PDF gespeicherten Reihenfolge, nur einfache Zeilenumbrüche werden rekonstruiert. Spalten, Tabellen und mathematische Notation können durcheinandergeraten – deshalb sind die Prüfungen oben wichtig.
Welche Seitenzahlen soll ich eingeben?
Positionen in der Datei, ab 1 gezählt, Deckblatt eingeschlossen. 1-3, 5 wählt zum Beispiel die ersten drei Seiten und die fünfte. Kommt eine Seite im Bereich zweimal vor, wird sie einmal extrahiert, in der von Ihnen eingegebenen Reihenfolge.
Was ist das seltsame Zeichen zwischen den Seiten?
Kopierter Text und TXT-Datei trennen die Seiten mit einem Seitenvorschubzeichen. Je nach Editor ist es unsichtbar oder erscheint als kleines Symbol oder als ^L. Sie können es als Seitenmarke behalten oder löschen.
Kann ich ein passwortgeschütztes PDF in Text umwandeln?
Mit dem iSomor-Werkzeug „PDF in Text umwandeln“ nicht. Es öffnet keine passwortgeschützten PDFs und keine Dokumente, die das Kopieren nicht erlauben. Verwenden Sie eine ungeschützte Kopie, die Sie verarbeiten dürfen.
Kostenloses Tool: PDF in Text umwandeln, läuft lokal im Browser