
Pourquoi traduire un PDF est-il si difficile ? Que cherchons-nous à préserver ?
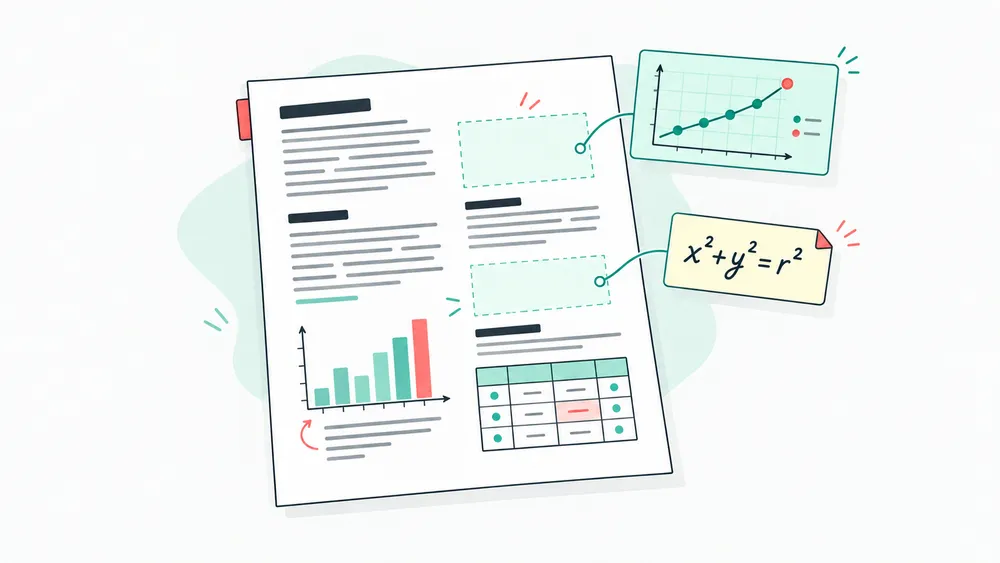
Dans notre précédent article, « Pourquoi conserver la mise en page d’un PDF traduit ? Regard sur nos habitudes de lecture », nous sommes partis de nos habitudes de lecture pour expliquer pourquoi une traduction de PDF ne devrait pas se réduire au texte traduit. Lorsque nous lisons un article scientifique, un rapport ou une documentation technique, nous parcourons les titres, cherchons les graphiques et passons de l’original à la traduction pour vérifier certains détails. La mise en page d’origine nous aide à mémoriser les liens entre ces éléments.
Mais préserver ces liens n’a rien d’évident sur le plan technique.
Traduire un PDF ne consiste pas simplement à remplacer une langue par une autre, puis à remettre les mots à leur place. Il faut aussi comprendre les composants de la page, déterminer quels textes vont ensemble et réorganiser le contenu lorsque sa longueur change après traduction.
La difficulté tient au fait qu’un PDF indique souvent où se trouve un élément, mais pas nécessairement à quoi il appartient. De quel titre dépend un paragraphe ? Quelle explication correspond à un graphique ? Quelle phrase définit un symbole dans une formule ? Il faut souvent déduire ces relations de la position, du style et du contexte. Colonnes, graphiques, formules et tableaux rendent cette déduction plus complexe.
Pourquoi une page PDF ne se lit pas comme une simple suite de texte
Quand nous modifions un document, nous savons généralement qu’un titre est un titre, qu’un paragraphe est un paragraphe et à quelle colonne appartient une donnée de tableau. Le PDF se rapproche davantage de l’apparence finale de la page : textes, traits, images et espaces blancs occupent leurs positions, sans toujours être accompagnés d’une structure explicite.
Un même paragraphe peut être découpé en nombreux blocs indépendants. Le texte d’un graphique peut être stocké séparément de ses éléments visuels. Un tableau peut n’être qu’un ensemble de lignes et de chiffres, sans lignes et colonnes formellement définies. Dans un PDF numérisé, la page est une image : textes, tableaux et formules doivent d’abord y être reconnus.
Avant de traduire, il faut donc répondre à plusieurs questions :
- Quels textes appartiennent au même paragraphe ?
- Quel titre correspond au contenu qui suit ?
- Dans quel ordre faut-il lire les deux colonnes ?
- À quelle figure ou à quel tableau se rapporte une explication ?
- Comment distinguer les en-têtes et pieds de page du corps du texte ?
Sans comprendre ces relations, extraire le texte, le traduire bloc par bloc puis le replacer dans l’ordre peut donner une page où chaque phrase est traduite, mais où l’on ne sait plus par où commencer.
La première étape n’est donc pas le remplacement des mots, mais la compréhension, autant que possible, de la structure de la page. Techniquement, cela ressemble davantage à la reconstruction des liens entre titres, paragraphes, figures et explications sur une page terminée qu’à la lecture d’une chaîne de caractères.
Avec deux colonnes, la vraie difficulté est l’ordre de lecture
Les articles scientifiques et les rapports techniques utilisent souvent deux colonnes. Ce que nous voulons préserver, ce ne sont pas deux bandes verticales, mais le parcours de lecture : quelle colonne lire d’abord, à quelle partie appartient un titre et à quel moment consulter une note de bas de page.
Une personne peut comprendre rapidement qu’il faut lire la colonne de gauche, puis celle de droite. Pour un système, toutefois, les positions du texte ne définissent pas automatiquement cet ordre.
Un paragraphe peut être fractionné en lignes, chacune reconnue comme un bloc distinct. En suivant uniquement les coordonnées ou l’ordre d’extraction, le contenu risque de sauter à droite avant la fin de la colonne gauche, de déplacer un titre, d’insérer une note au milieu du corps ou de rattacher à une seule colonne une figure qui s’étend sur les deux.
Le système doit donc traiter ensemble le découpage de la page, l’ordre des blocs et les éléments qui interrompent le flux habituel :
- Identifier les limites entre les colonnes.
- Reconnaître titres, corps du texte, notes, en-têtes et pieds de page.
- Retrouver l’ordre des blocs de texte.
- Après traduction, recalculer les retours à la ligne dans la largeur disponible.
- Vérifier que le lecteur peut toujours suivre l’ordre initial.
Si la traduction est plus longue, elle peut dépasser la zone d’origine. Maintenir chaque ligne à sa position initiale peut provoquer des chevauchements ou des espaces excessifs. Une bonne restitution ne fixe pas chaque caractère à ses anciennes coordonnées : elle préserve autant que possible l’ordre de lecture créé par les colonnes.
Un graphique n’est pas une image isolée, mais un ensemble d’informations liées
Les graphiques sont une partie souvent sous-estimée de la traduction de PDF. Il ne s’agit pas de conserver une image « à peu près identique », mais la correspondance entre éléments visuels, données, clés de lecture, légendes de figure et texte principal.
Pour le lecteur, une figure et le texte voisin font naturellement partie du même raisonnement. Dans le PDF, il peut s’agir d’objets indépendants, parfois même placés sur des couches de contenu différentes.
Le corps peut être entièrement traduit, mais si les titres, axes, légendes et annotations du graphique restent inchangés, le propos de l’auteur peut demeurer difficile à comprendre. Inversement, traduire uniquement les mots du graphique sans maintenir leur lien avec le texte principal et la légende de figure sépare aussi des informations qui vont ensemble.
Un graphique contient généralement plusieurs niveaux d’information :
- Un titre qui indique son sujet.
- Des axes et des unités qui permettent d’interpréter les chiffres.
- Une clé de lecture qui explique couleurs, lignes et symboles.
- Des annotations qui signalent un résultat ou une évolution.
- Une légende de figure et des renvois dans le texte qui précisent conditions et explications.
Ces éléments doivent être considérés comme un tout. Le système ne peut pas établir leurs liens en se fondant uniquement sur leur proximité :
- La légende peut se trouver sous la figure ou, à cause d’un saut de page, sur la page suivante.
- Dans une page à deux colonnes, le paragraphe le plus proche n’explique pas nécessairement le graphique.
- Un renvoi comme « voir figure 2 » peut désigner une figure éloignée.
- Les mots du graphique peuvent être du texte extractible ou être fusionnés avec l’image.
- Axes, clés de lecture et étiquettes doivent être traduits, sans modifier les chiffres ni les relations entre données.
La traduction doit tenter de préserver les liens entre données, visuels et explications, plutôt que de traiter uniquement les phrases extractibles. Le système doit reconnaître non seulement « il y a du texte ici », mais aussi le rôle de ce texte dans le graphique.
C’est pourquoi vérifier que les mots sont traduits ne suffit pas. Il faut aussi s’assurer que les légendes correspondent toujours aux bons éléments, que les unités sont présentes, que la description de la figure reste repérable et que « figure 2 » renvoie réellement à celle-ci. Un seul lien erroné peut changer la compréhension, même si le graphique est toujours visible.
Pour les formules, la difficulté tient aussi à ce qui les entoure
Une formule n’a généralement pas besoin d’être traduite. Ce qu’il faut préserver, c’est sa relation avec le texte environnant : définitions des variables, renvois aux numéros et conditions exprimées avant ou après.
Une variable peut être expliquée dans le paragraphe suivant, le numéro d’une formule cité dans le corps, et une condition voisine déterminer la validité d’une conclusion. Garder la formule tout en perdant ses liens avec les définitions, la numérotation ou le contexte ne la rend pas réellement utilisable.
Techniquement, les formules existent aussi sous différentes formes. Certaines combinent caractères et traits vectoriels ; d’autres sont déjà des images, sans la structure mathématique de l’éditeur d’origine. À l’extraction, exposants, indices, racines et lettres grecques peuvent être séparés ou confondus. Lors de la remise en page, une formule ne peut pas être coupée n’importe où comme une phrase ordinaire. Formule, numéro et référence doivent rester cohérents : une erreur de position ou d’ordre ne doit pas faire comprendre « équation (3) » comme une autre équation.
Il faut donc vérifier au minimum :
- Que symboles, exposants, indices et caractères spéciaux sont complets.
- Que les numéros correspondent aux références du texte.
- Que les définitions des variables restent près du passage concerné.
- Que la formule demeure lisible après un retour à la ligne.
- Que les explications voisines n’ont pas été séparées à tort.
Dans un article scientifique ou technique, constater que la formule « est encore là » n’est que le contrôle le plus élémentaire. Son rapport au texte qui la précède et la suit est tout aussi important.
Dans un tableau, un décalage peut changer le sens d’un chiffre
Préserver un tableau ne signifie pas seulement conserver bordures et traits. Il faut maintenir les relations entre lignes, colonnes, en-têtes, unités, notes et chiffres. Un nombre n’a son sens complet qu’avec la bonne ligne, la bonne colonne, le bon intitulé et la bonne unité.
Les fichiers réels peuvent contenir des cellules fusionnées, des en-têtes sur plusieurs pages, des colonnes sans bordure ou de simples textes alignés avec des espaces. Après traduction, une cellule plus longue peut affecter toute la largeur de la colonne. La replacer aux anciennes coordonnées peut provoquer un débordement, masquer la colonne suivante ou faire croire qu’un chiffre appartient à une autre ligne.
Il faut donc préserver la structure des lignes et colonnes, la hiérarchie des en-têtes, les unités et les notes, et pas seulement redessiner les traits au même endroit.
Quand la traduction s’allonge, la page doit retrouver un équilibre
Même après une identification correcte de la structure, un problème pratique subsiste : les langues n’occupent pas le même espace pour exprimer une idée. Il ne s’agit pas de conserver les coordonnées de chaque caractère, mais des relations spatiales claires entre titres, paragraphes, graphiques et formules.
Un paragraphe anglais traduit en chinois peut raccourcir, ou s’allonger à cause des termes, parenthèses et explications. Changer de langue modifie aussi les possibilités de coupure des mots, la disposition de la ponctuation et la largeur des polices. Tout cela influence la page finale.
Cela peut changer :
- Les retours à la ligne dans les deux colonnes.
- La nécessité pour un titre d’occuper deux lignes.
- L’espace restant à côté d’un graphique.
- Le risque de voir du texte dépasser d’une cellule.
- La capacité des zones d’origine à contenir toute la traduction.
La mise en page traduite ne peut donc pas simplement coller le nouveau texte dans les anciens cadres. Elle doit équilibrer proximité structurelle et confort de lecture.
Comment nous cherchons à préserver ces relations
Chez iSomor, la restitution de la mise en page fait partie de la traduction : ce n’est pas une décoration ajoutée à la fin. Le traitement actuel repose sur des PDF avec du texte extractible et relie reconnaissance de la disposition, organisation des paragraphes, traduction et placement du texte traduit. Les étapes suivantes expliquent ce que nous traitons et comment nous évaluons l’utilité du résultat. Elles ne signifient pas que toutes les relations complexes sont déjà reconnues et vérifiées automatiquement.
Commencer par des unités de contenu compréhensibles
L’analyse combine les positions du texte et les zones de mise en page pour distinguer autant que possible corps, titres, graphiques, formules et autres contenus, puis organiser les paragraphes à traduire. Le but n’est pas de multiplier les petits morceaux, mais d’éviter de séparer des textes liés ou de mélanger des régions distinctes.
Les tableaux en sont un exemple concret. Notre implémentation utilise les informations de zones de cellules pour aider le regroupement ultérieur des paragraphes : les lignes d’une même cellule doivent être traitées ensemble autant que possible, et les contenus de cellules différentes ne doivent pas se mélanger. Cela ne signifie pas que tous les tableaux soient correctement reconstruits. Les tableaux sans bordure, les en-têtes complexes et les cellules contenant plusieurs paragraphes peuvent encore entraîner des erreurs de regroupement et demandent une vérification.
Garder ensemble les informations liées, autant que possible
Reconnaître une figure ne suffit pas. L’utilité du résultat dépend aussi de la correspondance avec sa légende, sa clé de lecture et les renvois du texte. Il en va de même pour les formules, leurs numéros et les définitions des variables.
Il s’agit d’abord d’un objectif de restitution, non d’une promesse selon laquelle le système comprend toutes les références. Conserver les visuels, les numéros et la position des textes proches facilite la comparaison. Mais une page d’apparence complète ne prouve pas que les légendes sur une autre page, les renvois lointains ou les textes intégrés aux images ont été correctement traités.
Conserver le contexte nécessaire dans les paragraphes
Le traitement actuel traduit par paragraphe plutôt que de considérer chaque ligne comme une phrase indépendante. Organiser les paragraphes le plus correctement possible réduit la perte de contexte causée par une phrase coupée.
Ce regroupement ne garantit toutefois pas automatiquement la cohérence terminologique du document entier. Un même terme peut être traduit différemment dans un titre, le corps, une légende ou un tableau, notamment s’ils occupent des zones séparées. Nous recommandons de comparer les termes et conclusions importants à l’original, sans confondre traduction terminée et contrôle global de cohérence achevé.
Recalculer l’espace nécessaire à la traduction
Lorsque la longueur change, il faut ajuster les retours à la ligne et la disposition dans les zones disponibles, tout en conservant autant que possible graphiques, formules et autres contenus. La difficulté est qu’un paragraphe qui tient dans sa zone peut encore entrer en conflit avec les zones voisines.
Un titre passé sur deux lignes empiète-t-il sur le texte dessous ? Une légende plus longue dépasse-t-elle de sa zone ? Une cellule traduite touche-t-elle la colonne voisine ? Recomposer la page revient à chercher une disposition lisible entre des régions qui se contraignent mutuellement, pas à recoller chaque caractère à ses anciennes coordonnées. Nous ne présentons ni le recalcul automatique des largeurs de colonnes, ni le déplacement de figures entre pages, ni la repagination comme des résultats garantis pour tous les fichiers.
Le résultat ne sera pas forcément identique pixel par pixel. Il est plus important que l’on puisse distinguer titres et corps, retrouver l’explication d’un graphique et poursuivre le raisonnement initial.
Revenir à l’original pour vérifier contenu et mise en page
Une page nette n’est pas nécessairement correcte. La vérification doit distinguer trois types de problèmes : contenus manquants ou répétés, relations mal attribuées, chevauchements, coupures ou ordre incorrect. Ce sont des critères d’évaluation du résultat, pas l’affirmation que l’outil effectue déjà automatiquement tous les contrôles visuels et de contenu.
Un graphique peut être entièrement visible alors que son lien avec la légende est devenu flou. Une formule peut être présente avec des indices ou exposants mal placés. Un tableau peut sembler aligné alors qu’un chiffre est passé dans la colonne voisine. Il faut comparer contenu et structure pour repérer ces problèmes, pas seulement examiner une capture finale.
Pour les chiffres, termes, formules et conclusions, l’original reste une référence importante. Préserver la mise en page facilite la recherche et la comparaison, mais ne remplace pas le jugement du lecteur sur les informations essentielles.
Nous voulons un document que l’on peut continuer à lire, pas une image identique
« Restituer » peut donner l’impression que chaque caractère et chaque trait doivent rester exactement à leur place. Une fois la langue changée, cet objectif n’est pas toujours raisonnable.
Réduire fortement la taille du texte pour conserver le nombre de lignes, ou comprimer les paragraphes, peut rapprocher l’apparence de l’original tout en rendant la lecture plus difficile. À l’inverse, ajuster modérément retours à la ligne, corps de caractères ou interligne dans l’espace disponible peut aider à poursuivre la lecture, tant que les relations entre titres, graphiques, formules et explications restent claires.
Nous privilégions donc quelques questions concrètes :
- Le contenu a-t-il été conservé dans son intégralité ?
- L’ordre de lecture est-il clair ?
- Graphiques, formules et texte principal correspondent-ils toujours ?
- Le lecteur peut-il revenir à l’original pour vérifier un point ?
- La page se prête-t-elle encore à une véritable lecture ?
C’est le problème auquel iSomor souhaite répondre. Il ne s’agit pas de transformer un PDF en une suite de phrases traduites, mais de le garder utilisable comme document à lire, à consulter et à exploiter.
Les fichiers complexes demandent toujours une vérification
Les PDF varient fortement selon leur origine et leur mode de création. iSomor traite actuellement les PDF contenant du texte extractible ; l’OCR nécessaire aux pages entièrement numérisées n’entre pas dans le périmètre actuellement disponible. Même dans un PDF textuel, des tableaux imbriqués complexes, des polices particulières et du texte fusionné dans des images peuvent dépasser les limites du traitement automatique.
Après traduction, il reste donc utile de revenir à l’original, surtout pour les chiffres, formules, graphiques et conclusions importants d’un article scientifique. Nous ne considérons pas une mise en page soignée comme la preuve que tout le contenu est exact.
Pour nous, le rôle du travail technique n’est pas de transférer la complexité au lecteur, mais de traiter en amont autant que possible ce qui interromprait sa lecture. Chaque réorganisation ou recherche de correspondance évitée lui laisse un peu plus de place pour se concentrer sur le document lui-même.