
PDF 怎麼轉成 TXT 純文字?擷取文字後先檢查這 6 處
PDF 要轉成純文字,檔案裡必須先有文字層:擷取工具拿到的是檔案中儲存的文字,而不是頁面的影像。只匯出需要的頁面,存成 TXT 後對照原文檢查 6 處:空白頁、雙欄順序、頁首頁尾和頁碼、表格、公式與符號、亂碼。確認順序無誤後,最後再整理換行。 TXT 適合摘進筆記、引用原文、在文字編輯器裡搜尋長篇說明書,或把一段內容搬到別的文件裡。但它不是頁面的副本:字型、圖片、分欄和表格框線都沒了,文字的先後順序取決於這份 PDF 當初是怎麼產生的。
PDF 轉文字,到底會得到什麼?
純文字裡只有字元和換行。把 PDF 轉成文字,就是把檔案中以文字形式儲存的內容逐一讀出來,再排成一串。粗體標題變成普通的一行,表格變成一行行文字和數字,圖片則直接消失。
最容易讓人意外的是順序。PDF 記錄的是每段文字畫在頁面的什麼位置,不一定記錄「下一段是哪一段」。PyMuPDF 的文件說得很直白:純文字擷取不會替結果做任何美化,對 PDF 來說,輸出可能不是一般的閱讀順序,也可能出現意料之外的換行(原文:"output not in usual reading order, unexpected line breaks and so forth",見 PyMuPDF 文字擷取範例)。所以一份 TXT 可能一個字都不少,讀起來卻是亂的。
你的 PDF 裡有可以擷取的文字嗎?
轉換之前,先打開 PDF,用滑鼠試著選取一句話。
- 文字能一個個被選取:這一頁有文字層,擷取工具可以讀取。
- 一句話都選不到:這一頁很可能沒有文字層。擷取工具在這頁上沒有文字可讀,iSomor 的 PDF 擷取文字工具也不做 OCR。拿不準的話,直接用工具擷取一次,沒有可讀文字的頁面會列出來。
- 閱讀器要求輸入密碼,或提示禁止複製:檔案受到保護。請向檔案擁有者索取一份你有權處理、未加密的副本。
同一份檔案也可能兩種頁面都有,例如報告中插了幾頁簽名頁的圖片。這些頁面擷取不出文字,屬於正常現象。
PDF 轉 TXT 怎麼操作?
以下以 iSomor PDF 擷取文字 為例。它在瀏覽器裡讀取 PDF 既有的文字層,可以逐頁檢查後再取用文字。
- 選擇一份 PDF。每次處理一份文字型 PDF,最多 20 MB、200 頁。超過 200 頁的檔案,即使只選其中幾頁也無法處理。檔案在目前的瀏覽器中處理,不會上傳。
- 填寫要擷取的頁碼。留空代表全部頁面;也可以填
1-3, 5這樣的範圍。頁碼按檔案中的實際位置從 1 起算,封面也算一頁,所以可能和頁面上印的頁碼不同。只需要某一章時,只擷取那一章,之後要檢查的內容也少很多。 - 逐頁預覽。一頁頁翻看,和原文對照。如果所選頁面中有部分沒有可讀文字,會列出這些頁碼;略過了隱藏圖層文字的頁面也會列出(和閱讀器的顯示一致,預設隱藏的圖層文字不會擷取)。如果所選頁面全都沒有可讀文字,工具會提示「所選頁面沒有可讀文字」,不會產生 TXT。
- 複製或下載。可以複製全部文字,也可以下載 TXT。不論複製或下載,每兩頁之間都會插入一個換頁字元,頁與頁的邊界仍然保留。TXT 檔採用 UTF-8 編碼、LF 換行。
單頁最多 20 萬字元,合計最多 100 萬字元。檔案特別長的話,分幾次擷取。
使用 TXT 之前,要檢查哪些地方?
把原始 PDF 開在旁邊,先看下面這幾處。擷取出來的文字最常在這些地方出錯,而且每種問題的處理方式都不一樣。
| 檢查項目 | 在 TXT 裡的樣子 | 怎麼處理 |
|---|---|---|
| 空白頁 | 某些頁碼被列為沒有可讀文字,或提示所選頁面沒有可讀文字 | 先確認那一頁是不是圖片。不要因此認定整份檔案壞了,其他頁面可能都正常。 |
| 雙欄順序 | 左欄半句話接上了右欄半句話 | 縮小頁碼範圍重新擷取,和頁面對照。先別刪換行,刪了只會把問題藏起來。 |
| 頁首、頁尾、頁碼 | 段落中間夾著書名、章節名稱或頁碼 | 只刪除對照頁面確認過的行。單獨一行的數字也可能是章節編號或內文數據。 |
| 表格 | 儲存格變成一串文字和數字,順序也可能改變 | 引用任何數據前,先按原表把列與欄的關係理清楚。表頭和單位也要看,不能只看數字。 |
| 公式與符號 | 上下標、分數、負號、希臘字母被壓平或遺失 | 對照原文手動補上公式,或直接註明「見原文第幾頁」。 |
| 亂碼 | PDF 顯示正常,TXT 裡卻是方框、問號或錯字 | 這和檔案中字型的編碼方式有關,整理換行解決不了。可以設法找同一份文件的其他匯出版本。 |
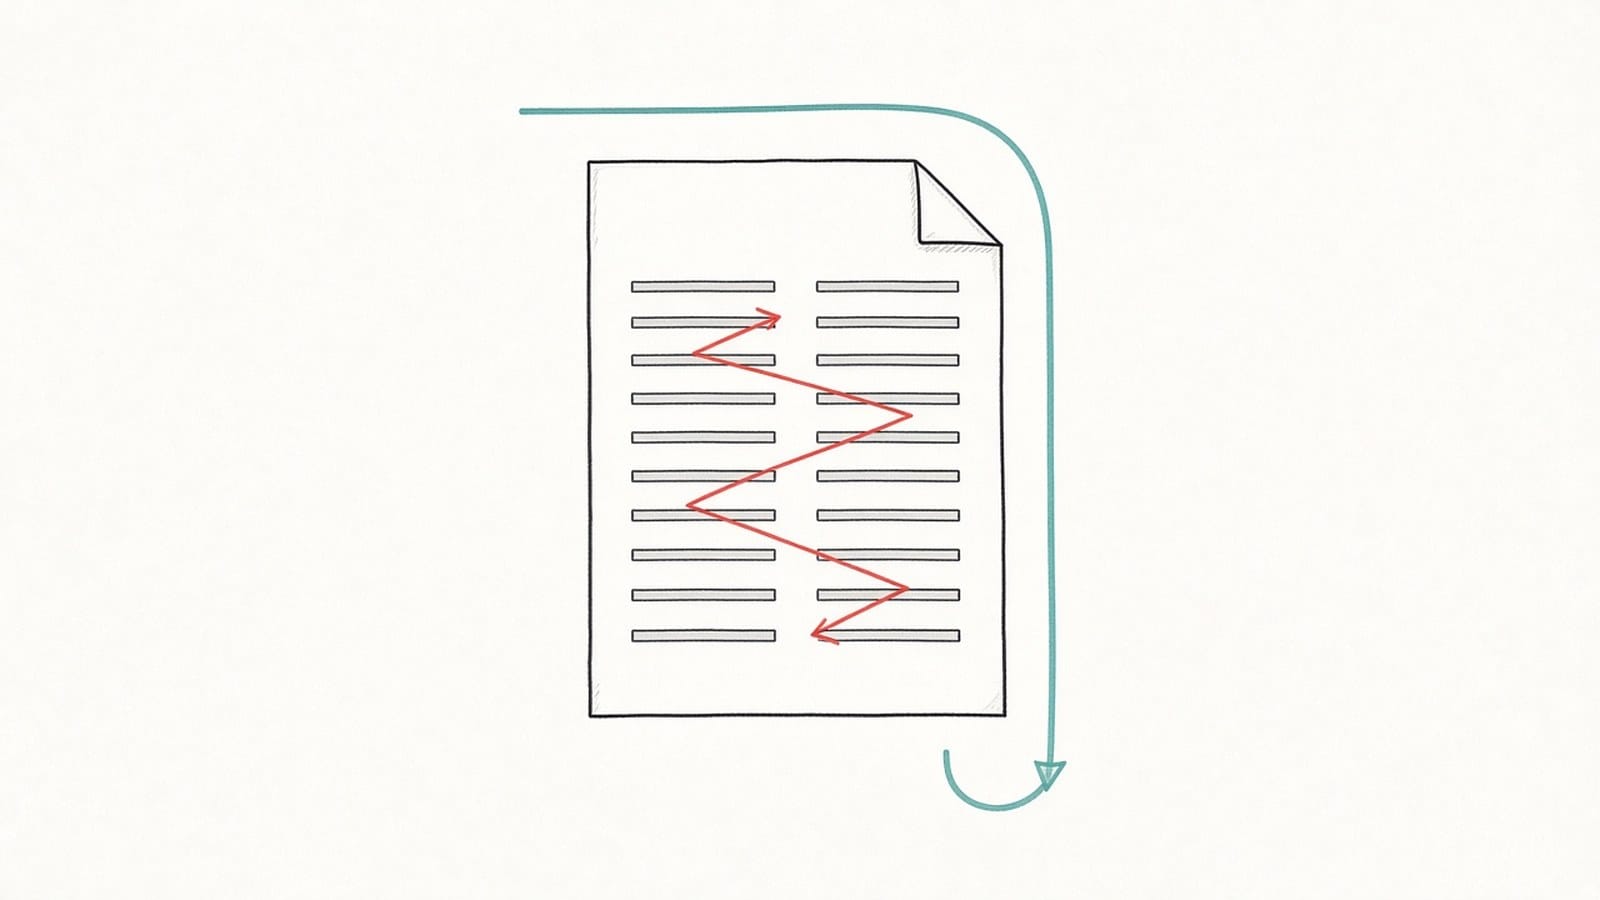
雙欄錯亂有它自己的成因。如果你要做的是翻譯而不是擷取,同樣的原因也會讓雙欄論文的譯文讀起來前後顛倒,詳見 雙欄 PDF 翻譯後閱讀順序亂了怎麼辦。
什麼時候整理換行?
順序對了以後再整理。擷取出來的文字常常在每個印刷行的行尾斷開,很容易想一口氣全部合併。但如果兩欄還混在一起,或段落中間還夾著頁尾,合併換行只會把錯誤的片段黏得更牢。
確認順序無誤後,合併段落內的單一換行、保留段落之間的空行,通常是安全的。標題、清單和行尾連字號要另外處理。從 PDF 複製出來的文字,為什麼總是亂的? 用 iSomor 文字格式整理工具 實際示範了這幾種情況,並附上處理前後的對照。
什麼情況下不該轉成純文字?
想要的是可以再利用的文字,純文字正合適。但如果版面本身就承載意義,例如需要逐列閱讀的表格、帶圖說的插圖、放在上下文裡的公式,轉成純文字就不合適了。
如果你真正的目的是讀懂一份外文 PDF,先轉 TXT 再翻譯,等於把這些上下文都丟掉了。iSomor 直接翻譯原始的文字型 PDF,並盡量保留頁面版式,你可以在原位置閱讀譯文,也可以下載 左右對照的雙語 PDF。哪些內容會留在頁面上,請見 iSomor 翻譯 PDF 時會保留版式嗎?。
常見問題
為什麼提示沒有可讀文字?
你選的頁面都沒有工具能讀取的文字層,所以不會產生 TXT。這些頁面很可能是掃描頁或存成圖片的頁面。擷取工具讀取的是檔案中儲存的文字,不會辨識圖片裡的字。條件允許的話,可以找由原始文件匯出的 PDF。
TXT 會保留 PDF 的版面嗎?
不會。文字按 PDF 中儲存的順序排列,只還原簡單的換行。多欄、表格和數學符號都可能錯位,所以上面的檢查才有必要。
頁碼應該怎麼填?
按檔案中的位置填,從 1 起算,封面也算。例如 1-3, 5 表示第 1 到 3 頁和第 5 頁。同一頁填了兩次只會擷取一次,順序依你填寫的先後排列。
頁與頁之間那個奇怪的符號是什麼?
那是複製的文字和 TXT 中用來分隔頁面的換頁字元。依編輯器不同,它可能完全看不見,也可能顯示成一個小符號或 ^L。可以留著當分頁標記,也可以刪掉。
加密的 PDF 能轉成文字嗎?
iSomor PDF 擷取文字沒辦法。它不開啟加密的 PDF,也不處理禁止複製的檔案。請使用你有權處理、未加密的副本。